Artificiële neurale netwerken
Neurale netwerken: historische achtergrond
In 1943 beeldden neurofysioloog Warren McCulloch en wiskundige Walter Pitts de werking van een neuraal netwerk uit met behulp van een eenvoudig elektrisch circuit. Ze lieten zich inspireren door de werking van biologische neurale netwerken in de hersenen van mensen en dieren. Hun model van het neuron nam verschillende "inputs" en maakte er een gewogen som van. Als output gaf het neuron een 0 als het resultaat onder een bepaalde drempel lag, en een 1 als het erboven lag.
In zijn boek The Organization of Behavior (1949) werkte Donald Hebb het idee verder uit. Hij stelde dat neurale paden sterker worden bij elk opeenvolgend gebruik, vooral tussen neuronen die tegelijkertijd "vuren". Zo begon de lange weg naar het begrijpen en modelleren van de complexe processen in de hersenen. Hebb's beroemde uitspraak, "Cellen die samen vuren, werken samen", vormde de basis van het zogenaamde "Hebbiaans leren". Drempellogica ('treshold logic'), die continue invoer omzet in 'discrete' (in afzonderlijke pakketten) uitvoer, was ook een belangrijke voorloper van de huidige kunstmatige neurale netwerken.
Het Massachusetts Institute of Technology, beter bekend als MIT, implementeerde in 1954 voor het eerst met succes een Hebbian-netwerk in een computersysteem. Rond die tijd probeerde Frank Rosenblatt, een onderzoekspsycholoog bij het Aeronautical Laboratory in Buffalo, uit te vinden welke "input" in het oog van een vlieg bepaalde in welke richting het insect zou vliegen. In zijn poging om dat "beslissingssysteem" wiskundig te kwantificeren, presenteerde hij in 1958 de Mark I Perceptron. Hij baseerde het op het neuron van McCulloch en Pitts. In de perceptron worden de gewichten van elke input "geleerd" door de "inputs" achter elkaar door te geven. Rosenblatt sloot zijn machine aan op een camera met 20x20 cadmiumsulfide fotocellen, waardoor hij een beeld van vierhonderd pixels kon produceren. In een demonstratie van de marine voor journalisten leerde de perceptron na vijftig pogingen links van rechts te onderscheiden.
The New York Times berichtte dat dit "brein" in staat was om beelden en informatie te onthouden die het zelf had waargenomen. Gewone computers, beweerde de journalist, waren alleen in staat om te "onthouden" wat ze via ponskaarten of magnetische banden binnenkregen. In een interview met dezelfde krant droomde de enthousiaste Rosenblatt hardop over perceptors die als "mechanische ruimteverkenners" naar andere planeten zouden worden gestuurd. In het begin," verklaarde Rosenblatt, "zal de Perceptron verkeerde beslissingen nemen, maar hij zal wijzer worden naarmate hij meer ervaring opdoet. De laboratoriumstaf droomde nog verder vooruit:
'De dienst zei dat het dit principe zal gebruiken om de eerste van zijn Perceptron denkmachines te bouwen die kan lezen en schrijven, naar verwachting over ongeveer een jaar klaar voor honderdduizend dollar.'
In 1959 ontwikkelden Bernard Widrow en Marcian Hoff in Stanford het eerste neurale netwerk dat met succes werd toegepast op een echt probleem. ADALINE en MADALINE, zo genoemd vanwege hun gebruik van Multiple ADAptive LINear Elements, elimineerden ruis in telefoonlijnen en worden vandaag de dag nog steeds gebruikt. Vergeleken met de eerdere perceptrons werkte dat neurale netwerk met "gewogen" invoergegevens.
De principes van de perceptron hebben bijgedragen aan de moderne revolutie in kunstmatige intelligentie. Deep learning' en neurale netwerken classificeren online afbeeldingen en vertalen teksten van de ene taal naar de andere.
Kunstmatige neurale netwerken
Kunstmatige intelligentie betekent dat computersystemen uit zichzelf leren om tot oplossingen te komen. We programmeren software om zelf te leren door ervaring of door voorbeelden, net zoals mensen en zelfs dieren dat doen. Computerwetenschappers gebruiken hiervoor verschillende leeralgoritmen. Ze proberen bijvoorbeeld de werking van neuronen in het menselijk brein na te bootsen met software. We spreken in dit geval van een "neuraal netwerk". De meeste dingen in ons leven leren we ook door voorbeelden van anderen. Zelfs op school moeten we leren van voorbeelden en fouten.
Door neurale netwerken in software te programmeren, kunnen computers zelf leren ("machine learning"). We voeden de AI-software eerst met trainingssets (of datasets). Dit kan bijvoorbeeld een reeks foto's van honden zijn. Door een massa foto's van honden als trainingssets aan de software te voeden, leert het neurale netwerk geleidelijk zelf honden op andere foto's te herkennen. Een belangrijk verschil is dat een mens minder voorbeelden nodig heeft dan een AI-algoritme. Een kind dat een paar keer een kat heeft gezien, zal snel ook andere katten herkennen. AI heeft een massa voorbeelden nodig. Een kat kan er immers heel verschillend uitzien, want er zijn bijvoorbeeld tientallen rassen. Daarnaast moet je een kat ook vanuit alle mogelijke "hoeken" (bovenaanzicht, achteraanzicht...) en tussen andere objecten in een afbeelding kunnen herkennen. Hiervoor moet een AI ook verschillende objecten kunnen segmenteren of van elkaar onderscheiden. Immers, als je een afbeelding of webcambeeld aan een AI laat zien, bestaat die inputdata alleen uit een reeks pixels met RGB-kleurwaarden. De AI moet dus op zoek naar patronen in pixeldata.
Gewichten
In ons leven moeten we voortdurend beslissingen nemen. Daarbij wegen we tal van factoren af. Welke kleren zullen we vandaag dragen? Welk cadeau zal ik kopen? Wat ga ik vanavond eten? Op wie zal ik stemmen bij de verkiezingen? Hier maak je veel afwegingen en sommige factoren wegen zwaarder in je uiteindelijke beslissing.
Op het einde tel je al die factoren bij elkaar op. Sommige wegen echter zwaarder. Op deze manier krijgt een neuraal netwerk (of het nu een stel neuronen in onze hersenen is of een kunstmatig neuraal netwerk) een heleboel 'inputs' (afwegingen), die elk hun eigen gewicht krijgen. Het netwerk "berekent" een beslissing en stuurt deze uit als een "output".
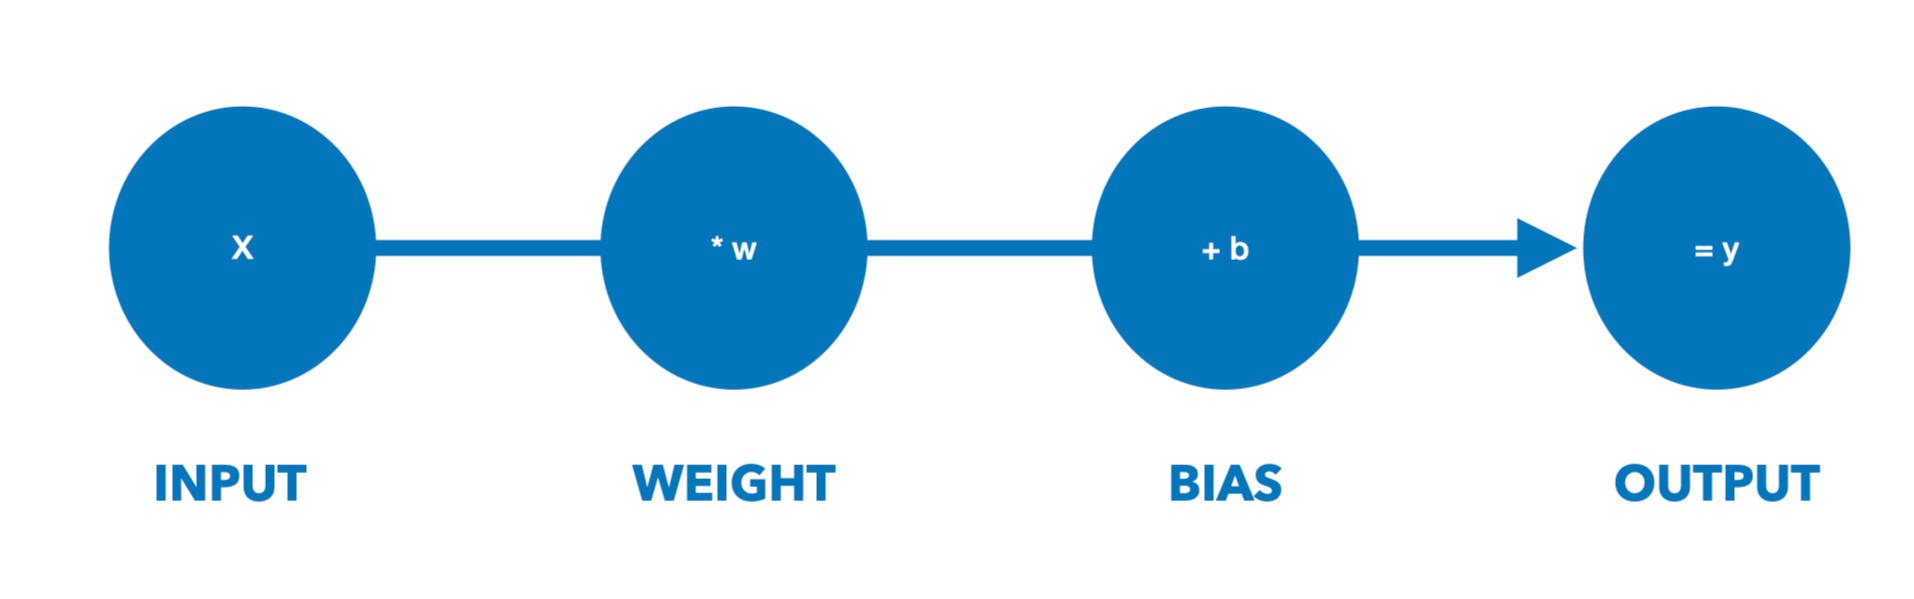
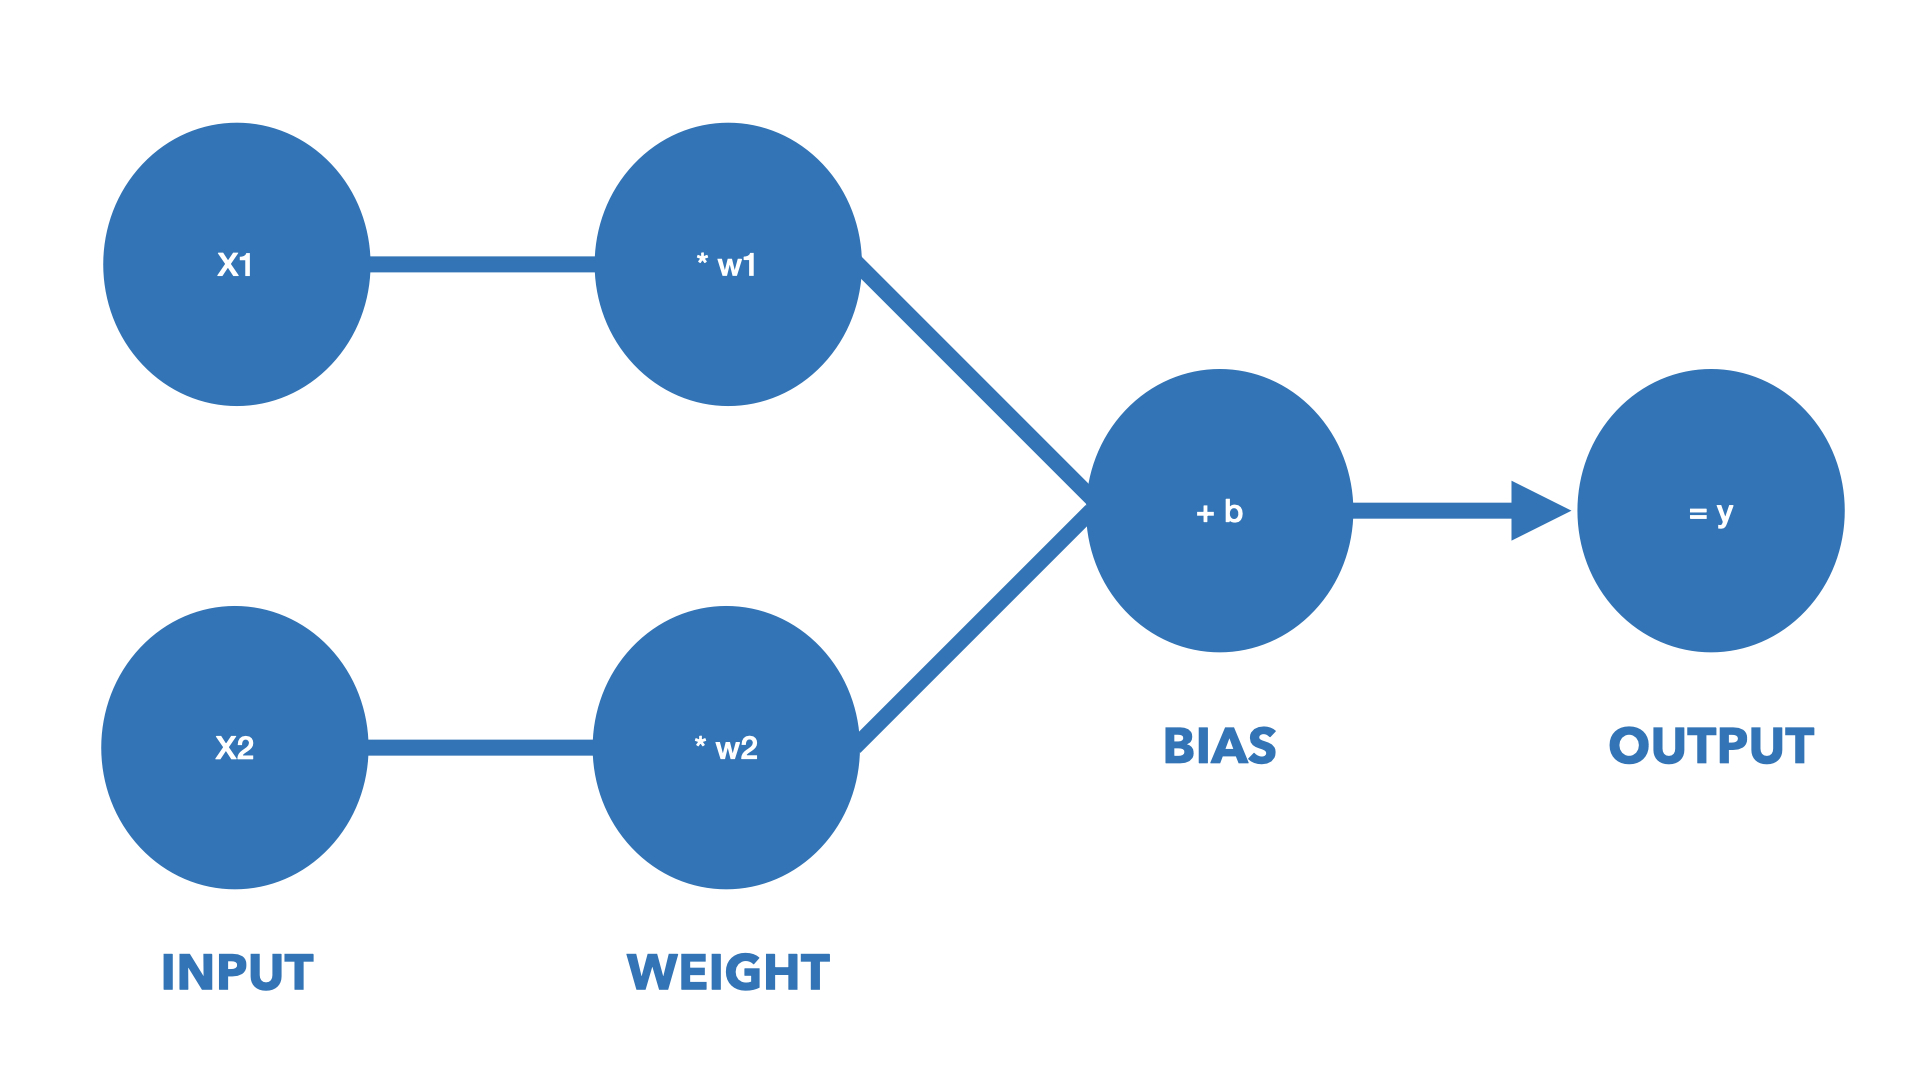
Het feit dat je een uitgebreide dataset/trainingsset aan je AI-algoritme geeft, betekent niet dat het vanaf dat moment foutloos zal werken. Een AI-algoritme kan leren van zijn fouten. In dit stadium is menselijke tussenkomst nog steeds belangrijk. Mensen kunnen nog steeds zelf controleren of de beslissing van het algoritme correct is. We spreken van begeleid leren of "supervised learning" of ... begeleid leren.
Een voorbeeld: een spamfilter
Een spamfilter is een bekend voorbeeld van AI-software op basis van een neuraal netwerk. Veel e-mails die het woord "casino" en "penisvergroting" bevatten, zullen spamberichten zijn. Maar stel dat je vriend je een e-mail stuurt met de tekst "Ga je vanavond met me naar het casino?", dan wil je niet dat dit bericht in de spam terechtkomt. Of als je echte problemen hebt en je dokter stuurt je een e-mail over je voortplantingsorgaan met de zin "We gaan je zieke penis verlengen" (Gelukkig krijg ik dit soort berichten niet van mijn dokter). dan wil je niet dat de combinatie "verlengen" en "penis" in hetzelfde bericht tot spam leidt. Het neurale netwerk moet veel afwegingen maken om te beslissen of een bericht wel of niet als spam moet worden gemarkeerd.
Je bouwt zo'n spamfilter door een reeks verdachte woorden samen te stellen. Berichten die een of meer van deze woorden bevatten, moeten worden herkend als spam. Die verdachte woorden worden geclassificeerd als 'true negative' (geen spam) in het ene bericht, en 'true positive' (zeker spam) in het andere. Andere termen kunnen leiden tot de classificatie 'vals positief' of 'vals negatief'. Dit gebeurt wanneer een spambericht onverwacht toch in uw gewone mailbox terechtkomt, of wanneer een goed bericht in uw spammap terechtkomt. In dat geval kunt u een bericht zelf classificeren. Op dat moment leert de spamfilter dat hij een fout heeft gemaakt. Het zal daar in de toekomst rekening mee houden. Spamfilters worden op die manier steeds beter en maken steeds minder fouten.
Daarom kun je zeggen dat AI software letterlijk voorspellingen doet op basis van wat de software eerder heeft geleerd. Die voorspellingen kunnen goed zijn ("true positive", "true negative"), maar ook heel fout ("false positive" of "true negative"). In dat laatste geval moet het algoritme worden aangepast.
Bij gesuperviseerd leren leert het algoritme van voorbeelden. Bij versterkt leren versterk je het algoritme door het te belonen of te straffen. Als de voorspelde output verkeerd of onvolledig is of tot een verkeerd resultaat leidt, kan de AI-software 'leren' van zijn eigen fouten. Stel dat een robot rondrijdt in een kamer die maar één uitgang heeft, dan kan die robot proberen eruit te komen door willekeurig tegen de muur te botsen tot hij de opening vindt. Maar als de robot eenmaal de deur heeft ontdekt, kan hij dit 'onthouden'.
Bij leren zonder toezicht ("unsupervised learning") krijgt het algoritme geen voorbeelden, maar moet het zelf elementen classificeren (categoriseren) op basis van gemeenschappelijke kenmerken. In unsupervised learning krijgt het algoritme dus vooraf geen voorbeelden of labels. Het algoritme moet de informatie zelf classificeren op basis van kenmerken. Stel dat je voor het eerst in je leven de was moet doen. Je ziet een stapel ongewassen kleren voor je. Nu moet je de was classificeren op basis van een aantal kenmerken. Classificeren op kleur en textielsoort zou de gewenste output zijn. Maar dat is wat het "algoritme" nu moet ontdekken. Als je het K-means algoritme gebruikt, kun je alleen van tevoren aangeven hoeveel groepen je wilt. De rest moet het algoritme zelf ontdekken.
Bij mensen komt vaak een combinatie van supervised en unsupervised learning voor. Een kind dat leert lopen krijgt wel hulp van volwassenen (zij houden toezicht of geven een 'helpende hand'), maar welke spieren de peuter moet gebruiken, dat leert de peuter letterlijk 'vanzelf' zonder toezicht.
Vaak proberen programmeurs een stukje van het menselijk brein na te maken. Ze gebruiken codes om een hersencel (neuron) na te maken, een zogenaamd "kunstmatig neuraal netwerk". Soms leert kunstmatige intelligentie door te vergelijken. Wanneer je een serie op Netflix bekijkt, vergelijkt Netflix jouw voorkeuren en selecties met die van andere mensen die dezelfde serie hebben bekeken. Netflix beveelt dan series aan die die andere mensen ook hebben bekeken. Kunstmatige intelligentie leert door waarschijnlijkheden te berekenen. Bijvoorbeeld: je hebt 50 procent kans dat de eerste leerling die je op school ontmoet een jongen is en 50 procent kans dat het een meisje is. Maar in een nonnenklooster is er bijna honderd procent kans dat je een vrouw tegenkomt. Een computer zou dat niet weten omdat hij die context niet kent. Als je die informatie aan de AI-software geeft, zal die een correctere voorspelling doen.
ANNs - kunstmatige neurale netwerken
Kunstmatige neurale netwerken of ANN's zijn statistische modellen die geïnspireerd en "gemodelleerd" zijn naar biologische neurale netwerken.
Kunstmatige neurale netwerken of ANN's zijn statistische modellen die geïnspireerd en "gemodelleerd" zijn naar biologische neurale netwerken. Menselijke hersenen bevatten naar schatting ongeveer honderd miljard neuronen. Die neuronen vormen netwerken die informatie uitwisselen en er ook van kunnen 'leren'. Hoe het precies werkt is nog niet helemaal duidelijk, maar dingen 'leren' zou gebeuren door verbindingen tussen neuronen te versterken. Beslissingen (van 'iemand in het gezicht slaan' tot 'kiezen tussen patat en shoarma') worden genomen op basis van de input die neuronen ontvangen. De output van het "netwerk" vormt de uiteindelijke beslissing.
ANNs zijn in staat niet-lineaire verbanden te leggen tussen invoergegevens en uitvoer (de beslissing).
ANNs kunnen niet-lineaire verbanden leggen tussen invoergegevens en uitvoer (de beslissing). Grofweg betekent dit dat het resultaat niet altijd een keuze voor of tegen is (een binaire beslissing), maar een gewogen schatting. De uiteindelijke beslissing is het resultaat van de som van meerdere inputs en het gewicht dat het netwerk aan elke input geeft. ANNs gebruiken verschillende algoritmen en kunnen ook verschillende vormen aannemen ("architecturen"). Om er een paar te noemen: Feed-forward neurale netwerken, Recurrente neurale netwerken, Multi-layer perceptrons (MLP), Convolutionele neurale netwerken, Recursieve neurale netwerken, Diepe overtuigingsnetwerken, Convolutionele diepe overtuigingsnetwerken, Self-Organizing Maps, Diepe Boltzmann machines, Gestapelde de-noising auto-encoders, Backpropagation, Gradient descent algoritme, Hebbiaanse leerregel, Zelforganiserende Kohonen regel, Hopfield netwerkwet, LMS algoritme (Least Mean Square), Competitief Leren. ..
Neurale netwerken kunnen meerdere lagen bevatten. We spreken dan van een "meerlagig perceptron".
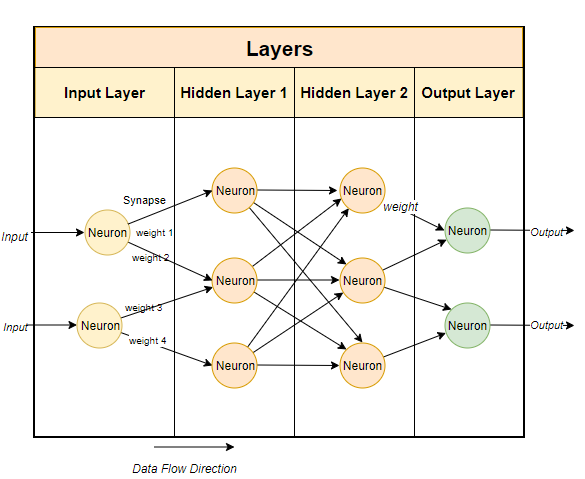
Neurale netwerken kunnen meerdere lagen bevatten. We spreken dan van een "meerlagig perceptron". Elke laag in zo'n netwerk probeert bijvoorbeeld patronen in een afbeelding te herkennen. Als er een patroon wordt gevonden, activeert het algoritme de volgende "verborgen" laag. De eerste laag herkent bijvoorbeeld randen in de afbeelding. De volgende laag combineert de gevonden randen, enzovoort. Hoe meer lagen een dergelijk netwerk bevat (hoe dieper het netwerk), hoe beter de patroonherkenning. Elke laag in het ANN kent gewichten toe (of vergroot of verkleint ze) telkens wanneer nieuwe gegevens (in dit geval, nieuwe afbeeldingen) het netwerk binnenkomen, en dat helpt bij het bepalen van de input van de volgende laag.
Deep learning
Wanneer meerdere "meerlaagse perceptrons" worden gecombineerd, wordt dit "diep leren" genoemd. Diep leren' splitst een probleem op in meerdere lagen.
Wanneer meerdere 'multilayer perceptrons' worden gecombineerd, wordt het 'deep learning' genoemd. Diep leren' splitst een probleem op in meerdere lagen. De eerste laag herkent bijvoorbeeld bepaalde vormen (cirkels, driehoeken...). De tweede laag identificeert dan bijvoorbeeld de 'ogen' (twee ronde of ovale vormen naast elkaar). De derde laag herkent dan het gezicht.... Uiteindelijk kan het algoritme het beeld van een mens herkennen.