AI met vooroordelen
Racistische AI
In 2016 presenteerde Microsoft Tay, een Twitterbot, een experiment in ‘conversational understanding’. ‘Hoe meer je met Tay chat,’ zei Microsoft, ‘hoe slimmer hij wordt, mensen leren betrekken door middel van een informeel en speels gesprek.’ Helaas bleven de gesprekken niet lang speels. Al vrij snel nadat Tay was gelanceerd, begonnen mensen de bot te tweeten met allerlei misogyne en racistische opmerkingen. In minder dan 24 uur veranderde Tay, gevoed met extremistische Twitterpraat, in een racistische bullebak. Waar liep het mis? Het mag duidelijk zijn dat AI-modellen niet altijd het gehoopte resultaat opleveren.
Op basis van de trainingsset en menselijke feedback heeft het algoritme bepaalde gewichten verhoogd en andere weer verlaagd. Als het ontwikkelteam merkt dat de controledata het gewenste resultaat opleveren, kan het model worden ingezet in de praktijk. Hoe en waarom het AI-model tot een conclusie komt, is op dat moment niet meer van belang. De predicties komen overeen met de gewenste resultaten.
Je kan niet met AI-modellen discussiëren en argumenteren waarom ze tot een bepaalde conclusie zijn gekomen.
Maar precies daar schuilt het probleem. Je kan niet met AI-modellen discussiëren en argumenteren waarom ze tot een bepaalde conclusie zijn gekomen. De reden waarom lijkt een gesloten boek, een zogenoemde ‘ black box’.
IBM trachtte zijn Watson-supercomputer te promoten als een belangrijk hulpmiddel bij kankeropsporing, maar de (menselijke) oncologen vertrouwden het systeem simpelweg niet. Twee oncologen kunnen discussiëren, maar dat kan je niet met een AI-model. Een AI kan niet beargumenteren waarom hij een bepaalde beslissing nam.
Van invoer tot uitvoer
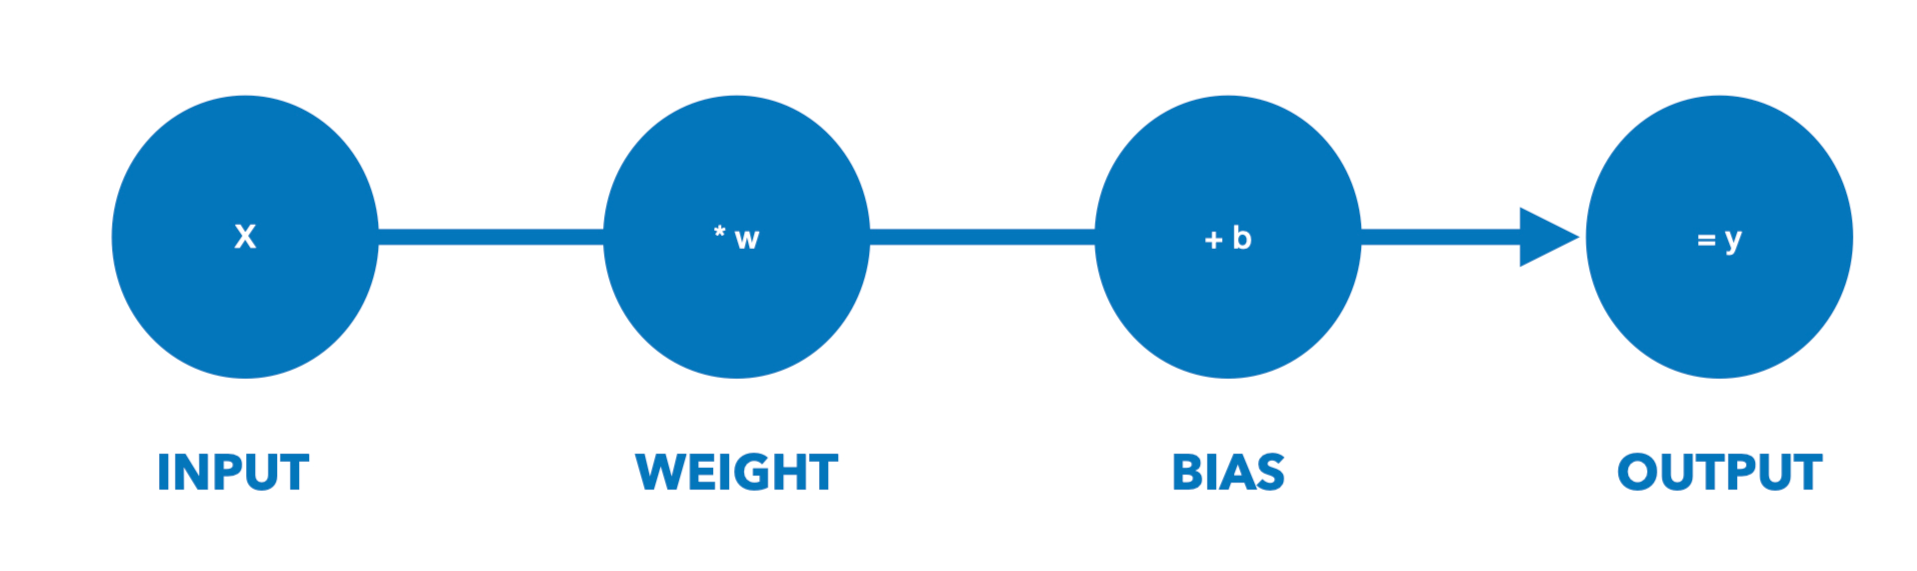
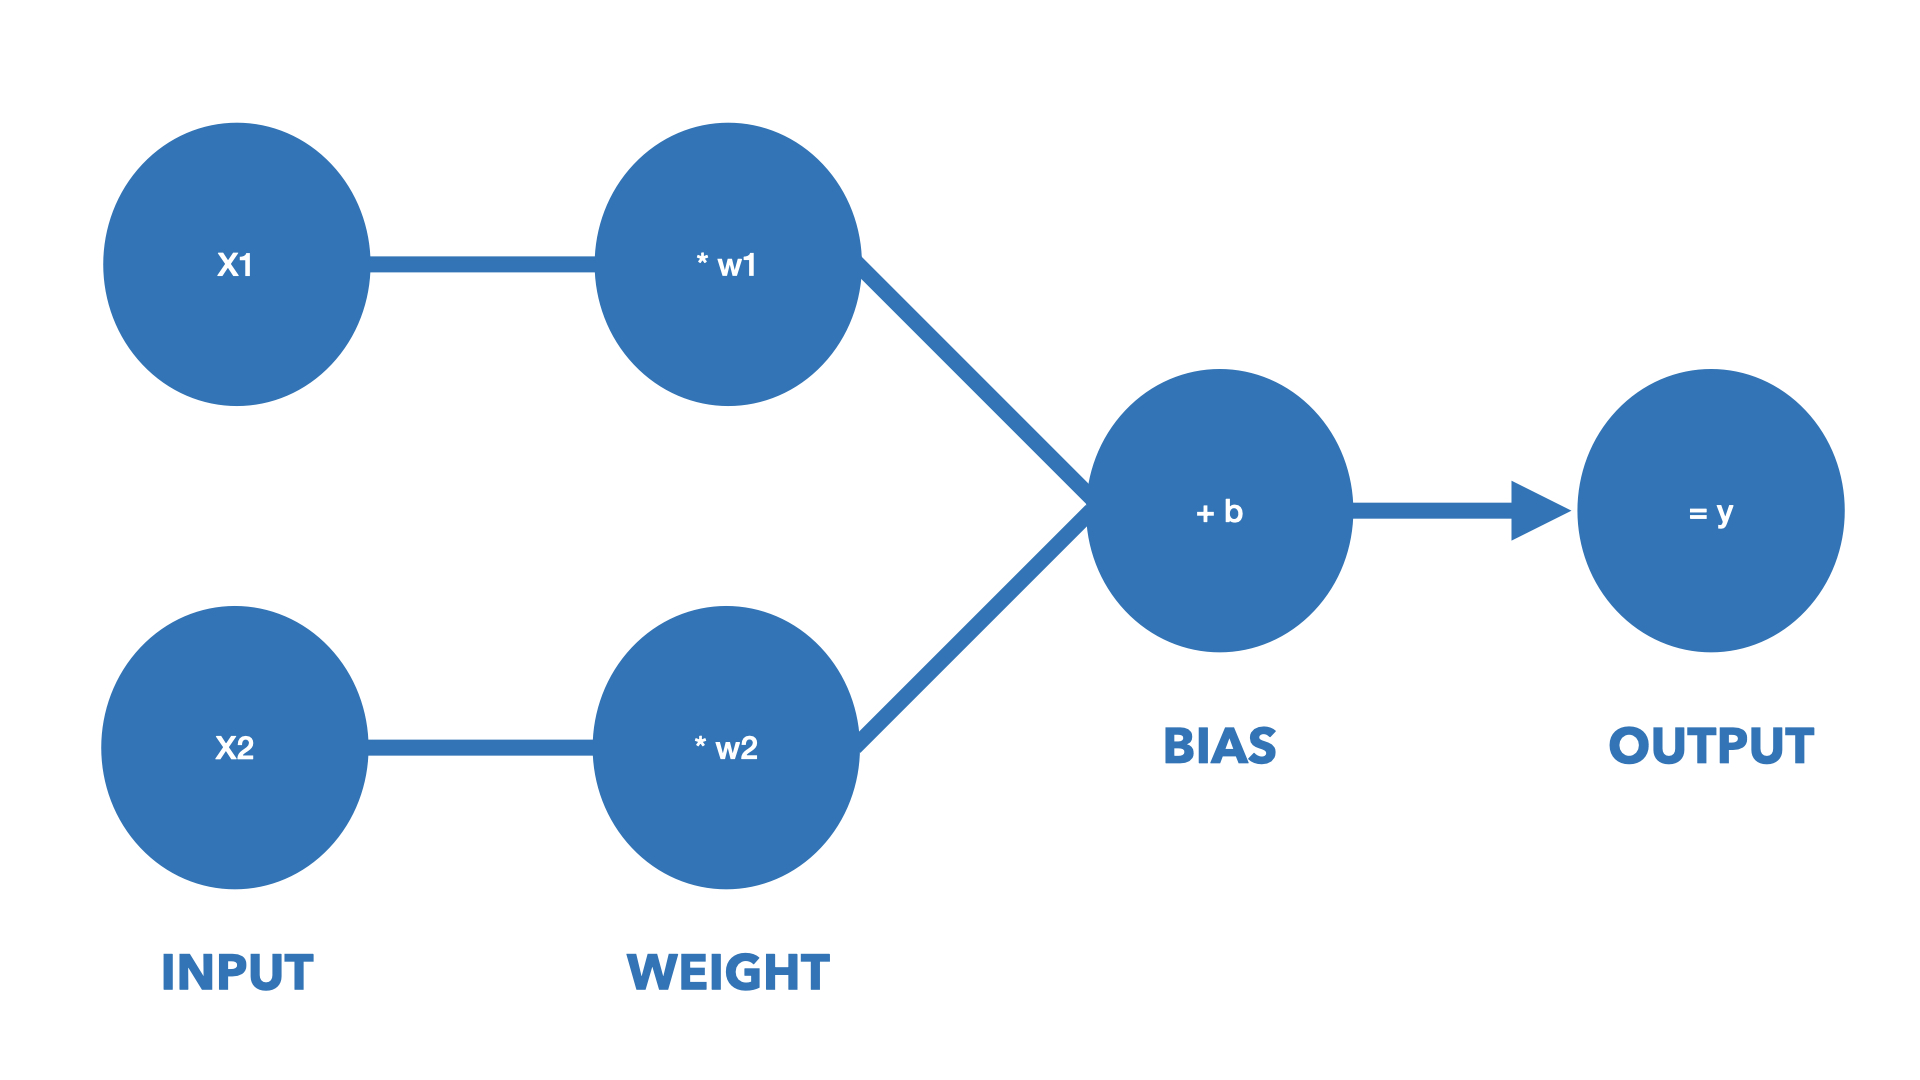
In de afbeeldingen hieronder krijg je nogmaals de werking van een AI-algoritme te zien:
- De invoervariabele(n)
- Het gewicht: als een bepaald variabele belangrijker is dan een andere, versterk je het gewicht. Hierdoor kan het algoritme "leren". Immers, als de uitvoer fout is, kunnen de gewichten worden bijgesteld.
- De "bias" (hierover leer je hieronder meer)
- De uitvoer.
Explainable AI
Alleen door AI-algoritmes en modellen verklaarbaar te houden, kan de ontwikkeling van AI onder controle worden gehouden.
Meer en meer groeit de eis dat AI-algoritmes verklaarbaar moeten zijn. Het moet duidelijk zijn hoe en waarom een model tot een bepaald besluit komt. Ook AI-critici en mensen die geloven in een dystopische toekomst waarbij AI de wereld overneemt, pleiten voor Explainable AI (XAI). Alleen door AI-algoritmes en modellen verklaarbaar te houden, kan de ontwikkeling van AI onder controle worden gehouden.
Stel dat een creditcardbedrijf wil weten of iemand kredietwaardig is. Een ontwikkelaar kan een AI-algoritme inzetten om te bepalen of dit het geval is voor elke gegeven gebruiker. Maar kredietwaardigheid is een subjectief en vaag gegeven. Iemand is minder kredietwaardig als het risico op betaalachterstanden groter is (bijvoorbeeld bij een laag salaris of hoog risico op werkloosheid). De geldverstrekker in kwestie kan er echter meer aan verdienen dan aan traditionele leningen.
Het bedrijf zal in eerste instantie zo veel mogelijk winst willen maken door zoveel mogelijk leningen toe te kennen die terugbetaald moeten worden tegen een maximale rente. ‘Kredietwaardigheid’ wordt op die manier geherformuleerd op basis van een zo hoog mogelijke winstmarge. Als het algoritme ontdekt dat het verlenen van leningen aan minder kredietwaardige mensen een effectieve manier is om de winst te maximaliseren, zal het uiteindelijk roofzuchtig gedrag vertonen, zelfs als dat niet de bedoeling van het bedrijf was.
Bias
Vooroordelen, ‘bias’ in het Engels, kunnen optreden wanneer de data die je verzamelt, niet helemaal representatief is voor de werkelijke situatie of bestaande vooroordelen weerspiegelt. Wat als je een stuk AI-software ontwikkelt voor het herkennen van gezichten, maar alleen gezichten van blanke mensen aan het systeem voedt als trainingsdata?
Amazon ontwikkelde een sollicitatietool die heel duidelijk een voorkeur had voor mannelijke kandidaten, omdat het leerde uit historisch data van het bedrijf. Welke attributen of eigenschappen je gaat gebruiken in de trainingsdata bepalen mede het eindresultaat. Neem de Amazon-sollicitatietool als voorbeeld: je kan ook het aantal jaren ervaring of de opleiding als attribuut als invoer gebruiken. Bij kredietwaardigheid speelt de leeftijd en het inkomen een bepalende rol, niet zo zeer de te behalen winst. Die vooroordelen blijken moeilijker op te lossen dan gedacht.
Wat zijn de oorzaken van AI-bias?
1 Onbekende onbekenden
Vaak stellen ontwikkelaars pas achteraf vast wat de effecten zijn van de gekozen attributen. In het geval van Amazon herprogrammeerden de ontwikkelaars de tool door alle geslachtgerelateerde woorden uit hun data te weren. Maar ook toen pikte het aangepaste systeem werkwoorden op die eerder met mannen correleren dan met vrouwen.
2 Training en controle
Vaak splitsen ontwikkelaars vooraf hun data op in een trainingsset en een controleset. Dit houdt in dat de controledata dezelfde vooroordelen bevat als de trainingsdata.
3 Gebrek aan sociale context
Computerwetenschappers of ontwikkelaars willen vooral systemen ontwikkelen die in meerdere situaties inzetbaar zijn. Juist doordat ze de sociale context buiten beschouwing laten, krijg je vooroordelen. Je kan geen sollicitatietool ontwikkelen voor Amazon en die eveneens gebruiken voor de werving en selectie van bouwvakkers.
4 Hoe meet je eerlijkheid?
Wanneer is er sprake van eerlijkheid en vooroordelen? Is Zwarte Piet racistisch? Vooroordelen komen overal en altijd voor, maar iedereen definieert ze anders. Ook in AI-data komen ze voor. Het verschil is echter dat ze voor AI mathematisch worden gedefinieerd.
Hoe kan je zulke vooroordelen voorkomen/oplossen?
Betekent dit dat je in alle situaties groepen gelijk moet laten voorkomen? Moeten in alle situaties vrouwen en mannen, mensen met een blanke of gekleurde huid, enzovoort, even sterk vertegenwoordigd zijn? Moeten vrouwen even hoog of vaak scoren in sollicitatieprocedures, ook al voldoen de groepen niet aan de andere noodzakelijke eisen?
AI-onderzoekers doen hun best om het probleem van ‘AI-bias’ aan te pakken. Ze proberen algoritmen te ontwikkelen die helpen bij het detecteren en verminderen van verborgen vooroordelen binnen trainingsgegevens of die de vooroordelen van het model verminderen, ongeacht de gegevenskwaliteit. Eenvoudig kan het niet worden opgelost. Het is een continu proces en we moeten er bij het ontwikkelen van AI-tools steeds bewust van zijn dat de resultaten of voorspellingen niet alleen het gevolg zijn van een mathematisch algoritme. Net zoals in alle andere aspecten van de samenleving is predictieve analyse nooit helemaal objectief.