Word Embeddings
Een computer tekstinzicht geven
Hoe kan een computersysteem dat eigenlijk alleen getallen "begrijpt" enig inzicht krijgen in de betekenis van woorden en meer nog, in de betekenis van een woord in de context van een zin of tekst?
Wanneer we computers gebruiken om taal te begrijpen, hebben we een manier nodig om woorden om te zetten in iets waar de computer mee kan werken. Een computer begrijpt meestal alleen binaire getallen, en via conversie ook decimale of hexadecimale getallen. Maar hoe kun je woorden en nog meer de betekenis van woorden in hun context omzetten in getallen? Eén manier om dit te doen is door "vectoren" te gebruiken om elk woord voor te stellen.
Wat is een "vector"?
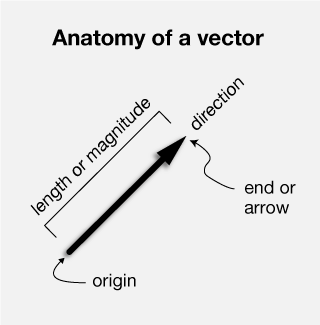
Een vector is een "speciale" pijl die ons helpt te laten zien hoe ver we moeten gaan en welke kant we op moeten om ergens te komen. Het is als een schatkaart die je vertelt hoeveel stappen je in een bepaalde richting moet nemen om de schat te vinden.
Stel je bijvoorbeeld voor dat je naar het huis van je vriend wilt, maar je weet niet waar het is. Je vraagt je moeder de weg en zij zegt dat je 5 blokken naar het noorden moet gaan en dan 3 blokken naar het oosten. Als we een pijl tekenen die begint op je huidige locatie en wijst in de richting van het huis van je vriend, dan stelt de lengte van de pijl de afstand voor die je moet afleggen en de richting van de pijl geeft aan welke kant je op moet. Dit is een vector!
We kunnen vectoren gebruiken om veel dingen in de wereld te beschrijven, zoals hoe snel een auto rijdt of in welke richting de wind waait. Ze helpen ons te begrijpen hoe dingen in onze wereld bewegen en veranderen.
Een vector met meerdere dimensies
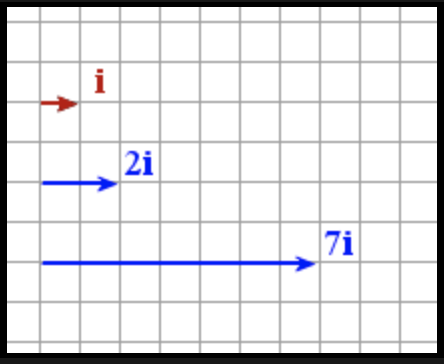
Een vector met één dimensie is als een gewoon getal dat heen en weer gaat op een getallenlijn. Als we bijvoorbeeld willen laten zien hoe ver weg een boom is, kunnen we een eendimensionale vector gebruiken die ons vertelt hoeveel stappen weg de boom is op de getallenlijn.
Maar soms moeten we meer dan één ding weten over een situatie.Bedenk bijvoorbeeld dat je een spel speelt waarin je een personage over een scherm beweegt. Om bij te houden waar het personage zich bevindt, moeten we zowel de positie van het personage langs de x-as (links en rechts) als de y-as (omhoog en omlaag) weten. Dit betekent dat we een tweedimensionale vector nodig hebben die ons vertelt hoe ver het personage naar links of rechts is en hoe ver omhoog of omlaag.
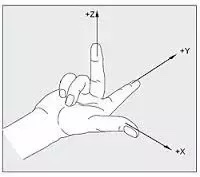
En soms hebben we nog meer informatie nodig! Als we bijvoorbeeld een vliegtuig besturen, moeten we niet alleen de hoogte van het vliegtuig weten (hoe hoog het is), maar ook de snelheid en richting. Dit betekent dat we een driedimensionale vector nodig hebben die ons vertelt hoe snel het vliegtuig beweegt in drie verschillende richtingen: op en neer, links en rechts, en vooruit en achteruit.
Vectoren kunnen dus meerdere dimensies hebben omdat we soms meer dan één ding tegelijk moeten bijhouden. Hoe meer dimensies een vector heeft, hoe meer informatie hij ons kan geven over een situatie!
Woordinbeddingen
Wanneer we computers gebruiken om taal te begrijpen, hebben we een manier nodig om woorden om te zetten in iets waar de computer mee kan werken. Een manier om dit te doen is door "vectoren" te gebruiken om elk woord voor te stellen.
Stel je voor dat we een grote lijst met woorden hebben, zoals "kat", "hond", "boom", "huis", enzovoort. We kunnen elk van deze woorden voorstellen als een vector met veel verschillende getallen erin. Elk nummer in de vector vertegenwoordigt een ander aspect van het woord, zoals hoe vaak het voorkomt, of met welke andere woorden het neigt voor te komen.
De vector voor "kat" kan bijvoorbeeld een hoog getal hebben voor "schattig" en "harig", en een laag getal voor "groot" en "zwaar". De vector voor "hond" kan hoge cijfers hebben voor "vriendelijk" en "trouw", en een laag cijfer voor "eng".
Door vectoren als deze te gebruiken, kunnen we computers leren de betekenis van woorden te begrijpen op basis van de getallenpatronen in hun vectoren. We kunnen deze vectoren ook gebruiken om woorden te vinden die op elkaar lijken, of om computers te helpen vertalen tussen verschillende talen.
Dus, woordinbeddingen in NLP (nlp = natural language processing) gebruiken vectoren om woorden voor te stellen, en deze vectoren kunnen computers helpen om taal te begrijpen en ermee te werken!
Hoe maak je een woordvector?
Wanneer we een vector maken om een woord voor te stellen, kiezen we welke kenmerken van het woord we willen weergeven met getallen.
We zeggen bijvoorbeeld dat we een vector willen maken voor het woord "appel". We kunnen besluiten dat we willen weergeven hoe zoet of zuur de appel smaakt, hoe groot of klein hij is en welke kleur hij heeft. We kunnen dus drie getallen in onze vector gebruiken om deze kenmerken weer te geven. We kunnen bijvoorbeeld een hoog getal geven aan zoetheid, een laag getal aan zuurheid, een gemiddeld getal aan grootte en een hoog getal aan roodheid.
Verschillende mensen kunnen verschillende kenmerken kiezen om in hun vectoren weer te geven, afhankelijk van waar ze de vectoren voor willen gebruiken. Als we bijvoorbeeld een vector maken om een computer te helpen bij het herkennen van verschillende soorten fruit, kiezen we misschien andere kenmerken dan wanneer we een vector maken om een computer te helpen bij het schrijven van een gedicht over fruit.
Dus, als we een vector voor een woord maken, kunnen we beslissen welke aspecten van het woord we met getallen willen weergeven. We kunnen verschillende kenmerken kiezen, afhankelijk van waar we de vectoren voor willen gebruiken!
Een menselijke taak
De beslissing welke kenmerken van een woord we willen weergeven met een getal in een vector wordt meestal door mensen genomen. Meestal werken experts op het gebied van natuurlijke taalverwerking (NLP) of machinaal leren aan de ontwikkeling van deze woordinsluitingen.
Om woordinsluitingen te maken, gebruiken onderzoekers algoritmen om grote hoeveelheden tekstgegevens te analyseren en patronen te identificeren in de manier waarop woorden samen worden gebruikt. Vervolgens gebruiken ze hun kennis van taal en hun expertise in het vakgebied om te selecteren welke kenmerken van een woord het belangrijkst zijn om in de vector weer te geven.
Onderzoekers kunnen bijvoorbeeld een grote verzameling nieuwsartikelen analyseren en vaststellen dat het woord "president" vaak samen wordt gebruikt met woorden als "overheid", "verkiezingen" en "beleid". Op basis van deze analyse kunnen ze besluiten dat hun vector voor "president" getallen moet bevatten die deze concepten vertegenwoordigen.
Dus, hoewel algoritmen worden gebruikt om gegevens te analyseren en patronen te identificeren, wordt de beslissing welke kenmerken in de vector moeten worden weergegeven uiteindelijk genomen door mensen met expertise op dat gebied.
De afstand meten
Wanneer we woorden als vectoren weergeven, kunnen we de afstand tussen de woorden meten, zelfs als ze verschillende kenmerken hebben.
Om dit te begrijpen, stellen we ons een grote doos met krijtjes voor. Elk krijtje heeft een andere kleur, maar we kunnen nog steeds de afstand tussen de krijtjes in de doos meten. We kunnen de krijtjes rangschikken van licht naar donker, of ze groeperen op basis van primaire kleuren.
Op dezelfde manier, wanneer we woorden als vectoren weergeven, kunnen we de afstand tussen de woorden meten op basis van hun numerieke waarden. We kunnen bijvoorbeeld het woord "banaan" weergeven met een vector die een hoge waarde heeft voor "geel" en "gebogen", terwijl het woord "regering" een hoge waarde kan hebben voor "politiek" en "macht". Hoewel deze woorden verschillende kenmerken hebben, kunnen we toch de afstand tussen hun vectoren meten.
Eén manier om de afstand tussen vectoren te meten is door gebruik te maken van de "cosinus overeenkomst". Dit is een manier om de hoeken tussen de vectoren te vergelijken, in plaats van alleen de afstand tussen hun numerieke waarden.
Met de cosinusovereenkomst kunnen we berekenen hoe gelijkaardig twee vectoren zijn, zelfs als ze verschillende kenmerken hebben. We kunnen bijvoorbeeld vaststellen dat het woord "overheid" meer gelijkenis vertoont met het woord "beleid" dan met het woord "banaan", ook al hebben deze woorden zeer verschillende kenmerken.
Om het te begrijpen, stel je voor dat je twee stukken speelgoed hebt die je wil vergelijken. Je kunt elk stuk speelgoed beschouwen als een lijst getallen die de verschillende kenmerken beschrijft. Bijvoorbeeld, het ene stuk speelgoed kan een score van 1 hebben voor zacht zijn, een score van 0 voor hard zijn en een score van 1 voor rood zijn. Ander speelgoed kan een score van 0 hebben voor zacht zijn, een score van 1 voor hard zijn en een score van 0 voor rood zijn.
Nu kun je deze lijsten met getallen gebruiken om de cosinusafstand tussen de twee stukken speelgoed te berekenen. Maak je geen zorgen over wat "cosinus" betekent, dat leggen we zo uit. Het belangrijkste om te begrijpen is dat de cosinusafstand een manier is om te meten hoe verschillend de twee speeltjes van elkaar zijn op basis van deze scores.
Zie de cosinusafstand als een liniaal die meet hoe ver twee dingen uit elkaar liggen. Hoe verder het speelgoed uit elkaar ligt, hoe hoger de cosinusafstand zal zijn. En hoe dichter bij elkaar, hoe lager de cosinusafstand.
Waarom heet het dan de cosinusafstand? Nou, "cosinus" is gewoon een mooi woord voor een soort wiskundige functie die wordt gebruikt om de afstand tussen de twee speeltjes te berekenen. Maar daar hoef je je geen zorgen over te maken. Het belangrijkste is dat de cosinusafstand een manier is om te meten hoe verschillend twee dingen van elkaar zijn op basis van een lijst met scores of kenmerken.
Dus, door vectoren te gebruiken om woorden voor te stellen en hun afstand te meten met de cosinus gelijkenis, kunnen we woorden met verschillende kenmerken vergelijken en toch begrijpen hoe gelijkaardig of verschillend ze zijn.
Cosinus gelijkenis is gelijkaardig aan cosinus afstand, maar in plaats van te meten hoe verschillend twee dingen zijn, meet het hoe gelijkaardig ze zijn.
Laten we hetzelfde speelgoedvoorbeeld van eerder gebruiken. Stel dat je twee stukken speelgoed hebt en je wilt ze vergelijken op basis van hun kenmerken. U kunt elk stuk speelgoed beschouwen als een lijst met getallen die de kenmerken beschrijft, zoals hoe zacht het is, welke kleur het heeft, enz.
Om de cosinus gelijkenis tussen de twee speeltjes te berekenen, gebruik je dezelfde lijst met getallen om te meten hoe gelijk ze zijn. Je meet de hoek tussen de twee lijsten met getallen en hoe dichter de hoek bij nul ligt, hoe meer het speelgoed op elkaar lijkt.
Zie de cosinus als een thermometer die meet hoe warm of koud iets is. Hoe heter iets is, hoe meer het lijkt op andere hete dingen. En hoe kouder iets is, hoe meer het lijkt op andere koude dingen.
Waarom wordt het dan cosinus gelijkenis genoemd? Nou, "cosinus" is gewoon een mooi woord voor een soort wiskundige functie die wordt gebruikt om de gelijkenis tussen de twee speeltjes te berekenen. Maar daar hoef je je niet al te veel zorgen over te maken. Het belangrijkste is dat cosinus gelijkenis een manier is om te meten hoe gelijkaardig twee dingen zijn op basis van een lijst van kenmerken.
Gecontextualiseerde woordinbeddingen
Een AI-taalmodel zoals ChatGPT heeft niet één vaste set vectoren voor alle woorden. In plaats daarvan gebruikt het model een techniek genaamd gecontextualiseerde woordinsluitingen, waarbij de vectoren voor elk woord ter plekke worden gegenereerd op basis van de context waarin het woord voorkomt.
Wanneer je ChatGPT een vraag stelt of een prompt geeft, analyseert het de tekst om de betekenis en context van de woorden die je gebruikt te begrijpen. Dan genereert ChatGPT een vectorrepresentatie voor elk woord dat rekening houdt met de context waarin het voorkomt.
Als je het model bijvoorbeeld de vraag stelt "Wat is een hond?", genereert het een andere vector voor het woord "hond" dan wanneer je vraagt "Wat is een hotdog?". In het eerste geval zou de vector voor "hond" nauwer verbonden zijn met het concept van een dier met vier poten, terwijl in het tweede geval de vector voor "hond" nauwer verbonden zou zijn met het concept van een soort voedsel.
Met deze techniek kan het model meer genuanceerde en accurate representaties genereren voor elk woord, gebaseerd op de context waarin het voorkomt. Dus terwijl het model niet dezelfde vectorkarakteristieken gebruikt voor alle woorden die het kent, kan het on-the-fly vectoren genereren die zijn aangepast aan de specifieke context waarin de woorden worden gebruikt.
Samenvatting
Woordinbedding is een techniek die wordt gebruikt in natuurlijke taalverwerking (NLP) om woorden weer te geven als numerieke vectoren. Het doel van woordinbedding is om de semantische en syntactische relaties tussen woorden vast te leggen op een manier die gemakkelijk kan worden begrepen en verwerkt door algoritmen voor machinaal leren.
Het voorbeeld van de banaan
Een populaire methode voor het genereren van woordinbeddingen is het gebruik van neurale netwerken. Het neurale netwerk wordt getraind op een groot corpus tekst en tijdens het trainingsproces leert het om een unieke numerieke vector toe te wijzen aan elk woord in de woordenschat. Deze vectoren staan bekend als "woordinbeddingen."
hier is een voorbeeld van een woordinbedding of (in dit geval) een 10-dimensionale vector voor het woord "banaan":
[0,452, -0,739, 0,817, 0,223, 0,094, -0,632, 0,222, -0,072, 0,512, -0,210]
Elk getal in deze vector vertegenwoordigt een ander aspect van het woord "banaan". Het eerste getal (0,452) kan bijvoorbeeld staan voor de fruitigheid van het woord, terwijl het tweede getal (-0,739) staat voor de vorm. De vector als geheel vertegenwoordigt de betekenis van het woord op een manier die gemakkelijk kan worden verwerkt door een algoritme voor machinaal leren.
Een "vectorrepresentatie" verwijst gewoon naar het feit dat het woord wordt weergegeven als een numerieke vector. In NLP gebruiken we vaak vectoren om woorden, zinnen en zelfs hele documenten voor te stellen, omdat ze gemakkelijk wiskundig te manipuleren zijn en kunnen worden gebruikt om overeenkomsten en afstanden tussen verschillende stukken tekst te berekenen.
Een numerieke vector is een wiskundig object dat bestaat uit een verzameling getallen gerangschikt in een specifieke volgorde. In NLP worden numerieke vectoren vaak gebruikt om tekstgegevens, zoals woorden, zinnen of documenten, weer te geven op een manier die gemakkelijk kan worden verwerkt door algoritmen voor machinaal leren.
Elk getal in deze vector vertegenwoordigt een ander aspect van het woord "banaan", en de vector als geheel vertegenwoordigt de betekenis van het woord in een numerieke vorm die kan worden gebruikt in wiskundige bewerkingen.
In het algemeen kunnen numerieke vectoren een willekeurig aantal dimensies hebben, en de waarden in elke dimensie kunnen een willekeurig reëel getal zijn. Vectoren kunnen worden opgeteld, afgetrokken, vermenigvuldigd en gedeeld, en ze kunnen ook worden gebruikt om afstanden en overeenkomsten tussen verschillende vectoren te berekenen. Dit maakt vectoren tot een krachtig hulpmiddel voor het representeren en verwerken van gegevens op veel verschillende gebieden, waaronder NLP, computer vision en machine learning.
De afstand tot de banaan meten
Eén manier om te meten welke woorden (of woordvectoren) "dicht" bij elkaar liggen is door een afstandsmaat te gebruiken, zoals cosinusovereenkomst of Euclidische afstand. Deze afstandsmetriek kan worden gebruikt om de gelijkenis of afstand tussen twee vectoren te berekenen, wat ons een indicatie kan geven van hoe "dichtbij" of "gelijkaardig" de twee vectoren zijn.
Cosinus overeenkomstis een van de meest gebruikte afstandsmetingen in NLP. Het meet de cosinus van de hoek tussen twee vectoren in een hoog-dimensionale ruimte. Hoe dichter de cosinusovereenkomst bij 1 ligt, hoe meer de vectoren op elkaar lijken, terwijl een cosinusovereenkomst van 0 aangeeft dat de vectoren volledig van elkaar verschillen.
Euclidische afstandmeet de rechte-lijn-afstand tussen twee vectoren in een hoog-dimensionale ruimte. Hoe kleiner de Euclidische afstand, hoe dichter de vectoren bij elkaar liggen.
Om de gelijkenis of afstand tussen twee woordvectoren te berekenen met behulp van cosinusgelijkenis of Euclidische afstand, nemen we gewoon het dotproduct of het verschil tussen de twee vectoren, respectievelijk, en normaliseren we het resultaat. Hier is een voorbeeld van hoe we de cosinusovereenkomst tussen twee woordvectoren kunnen berekenen:
Door de gelijkenis of afstand tussen verschillende woordvectoren te meten, kunnen we inzicht krijgen in de semantische en syntactische relaties tussen verschillende woorden, wat nuttig kan zijn voor een groot aantal NLP-taken, zoals sentimentanalyse, tekstclassificatie en automatische vertaling.
Het vastleggen van semantische relaties met "banaan"
Hoe kan het woord "banaan" gerelateerd zijn aan zowel "aap" als "ijs"?
Een veelgebruikte methode om de semantische relaties tussen woorden te onderzoeken met behulp van woordinbeddingen is om te kijken naar de dichtstbijzijnde burenvan een bepaald woord in de inbeddingsruimte. De naaste buren zijn de woorden die de meest gelijkende woordvectoren hebben met het doelwoord.
Dus, laten we zeggen dat we een woordinbedding hebben getraind op een groot corpus tekst, en we willen de semantische relaties van het woord "banaan" in deze inbeddingsruimte onderzoeken. We kunnen kijken naar de dichtstbijzijnde buren van "banaan" op basis van cosinusovereenkomst en zien welke andere woorden er het meest op lijken.
Hier zijn de top 5 naaste buren van "banaan" in een voorgetrainde woordinbedding:
- banaan
- fruit
- mango
- ananas
- papaya
Zoals je kunt zien zijn de meeste naaste buren van "banaan" andere fruitsoorten, wat logisch is omdat ze dezelfde eigenschappen hebben, zoals eetbaar zijn en aan bomen groeien.
Nu kijken we naar de dichtstbijzijnde buren van "banaan" die verwant zijn aan "aap":
- aap
- gorilla
- chimpansee
- orang-oetan
- aap
In dit geval zijn de naaste buren van "banaan" allemaal verschillende soorten primaten, wat logisch is omdat primaten graag bananen eten en er vaak mee worden geassocieerd.
Kijken we tot slot naar de dichtstbijzijnde buren van "banaan" die verwant zijn aan "ijs":
- ijsroom
- gelato
- sorbet
- diepvries-yoghurt
- aardbei
In dit geval zijn de dichtstbijzijnde buren van "banaan" allemaal verschillende soorten diepvriesdesserts, wat logisch is aangezien bananen vaak worden gebruikt als smaakstof in ijs en andere diepvriesproducten.
Zo, zoals je kunt zien, kunnen woordinbeddingen de semantische relaties tussen woorden vastleggen op een manier die weergeeft hoe mensen taal begrijpen en gebruiken. Door de naaste buren van verschillende woorden in een inbeddingsruimte te onderzoeken, kunnen we inzicht krijgen in hoe verschillende woorden aan elkaar gerelateerd zijn en welke eigenschappen ze delen.
De relaties opsporen
Woordinbeddingen worden meestal gemaakt met behulp van ongesuperviseerde leeralgoritmendie worden getraind op grote hoeveelheden tekstgegevens, zoals nieuwsartikelen of webpagina's. Tijdens het trainingsproces traint het algoritme de algoritmen. Tijdens het trainingsproces leert het algoritme een numerieke vector toe te wijzen aan elk woord in het corpus op basis van de co-incidentiepatronen met andere woorden in de tekst. Dit betekent dat woorden die in vergelijkbare contexten voorkomen vergelijkbare vectoren krijgen toegewezen, wat hun semantische gelijkenis weergeeft.
Om de semantische relatie tussen woorden in een woordinsluiting te detecteren, kunnen we afstandsmetingen zoals cosinusovereenkomst of Euclidische afstand gebruiken om de overeenkomst of afstand tussen de woordvectoren te meten. In het geval van "banaan" en "aardbei" is het waarschijnlijk dat hun vectoren vergelijkbaar zijn omdat ze allebei fruitsoorten zijn en vaak in vergelijkbare contexten voorkomen. Daarom zal hun cosinusovereenkomst of Euclidische afstand relatief klein zijn vergeleken met de afstand tussen "chimpansee" en "aardbei".
De reden waarom woordinbeddingen semantische relaties tussen woorden kunnen vastleggen, is dat de vectoren informatie coderen over de betekenis en het gebruik van woorden op basis van hun co-incidentiepatronen in het trainingscorpus. Als het woord "banaan" bijvoorbeeld vaak voorkomt in dezelfde context als woorden als "fruit", "zoet" en "geel", zal de woordinbedding leren om een vector aan "banaan" toe te wijzen die lijkt op de vectoren van andere woorden die ook vaak voorkomen in die contexten.
Een woordinbedding zal leren om een vector aan "banaan" toe te wijzen die lijkt op de vectoren van andere woorden die ook vaak voorkomen in die contexten.
Door te kijken naar de naaste buren van een woord in de inbeddingsruimte, kunnen we zien welke andere woorden er het meest op lijken op basis van hun co-incidentiepatronen in het trainingscorpus. Dit kan ons helpen om semantische relaties tussen woorden te identificeren die misschien niet direct duidelijk zijn aan de hand van hun oppervlaktevorm of woordenboekdefinitie.
Om een vergelijkbare context te detecteren, gebruiken woordinbeddingen meestal een techniek die " distributionele semantiek" wordt genoemd. Dit betekent dat woorden die in vergelijkbare contexten voorkomen, worden verondersteld vergelijkbare betekenissen te hebben. De context van een woord verwijst naar de woorden die eromheen voorkomen in een gegeven tekst of corpus.
Als het woord "banaan" bijvoorbeeld vaak voorkomt in dezelfde contexten als woorden als "fruit", "geel" en "schil", dan zal de woordinbedding leren om "banaan" voor te stellen als semantisch vergelijkbaar met deze andere woorden.
Schuifvensters
De context van een woord kan op verschillende manieren worden gedefinieerd, afhankelijk van het specifieke algoritme dat wordt gebruikt om de woordinbedding te maken. Een veelgebruikte aanpak is het gebruik van een "glijdend venster", waarbij een vast venster van een bepaald aantal woorden over het tekstcorpus wordt bewogen en de woorden binnen dat venster worden gebruikt om de context van elk woord te definiëren.
Als we bijvoorbeeld een schuifvenster van grootte 5 gebruiken, dan beschouwen we voor elk woord in het tekstcorpus de 5 woorden links en de 5 woorden rechts van dat woord als de context. Dit betekent dat twee woorden die in vergelijkbare contexten voorkomen in het tekstcorpus waarschijnlijk vergelijkbare vectorrepresentaties hebben in de inbeddingsruimte.
Er zijn ook meer geavanceerde technieken om context te definiëren, zoals het gebruik van neurale netwerken of probabilistische modellen om de meest informatieve context voor elk woord te leren.
Al met al is het doel van distributiesemantiek om de betekenis van woorden vast te leggen op basis van hun gebruikspatronen in een gegeven tekstcorpus. Door de contexten waarin woorden voorkomen te analyseren, kunnen woordinbeddingen leren om woorden weer te geven op een manier die hun semantische relaties met andere woorden in het corpus weerspiegelt.
Laten we zeggen dat we de volgende zin hebben:
"Ik heb de rijpe banaan gepeld en als ontbijt gegeten."
Als we een schuifvenster van grootte 5 gebruiken, bewegen we het venster als volgt over de zin:
- " Ik pelde derijpe banaanen at hem als ontbijt." (venster gecentreerd op "de")
- "Ik pelde de rijpebanaan enat hem als ontbijt." (venster gecentreerd op "rijp")
- "Ik pelde de rijpe banaanen athem als ontbijt." (venster gecentreerd op "banaan")
- "Ik pelde de rijpe banaan enat hemals ontbijt." (venster gecentreerd op "en")
- "Ik pelde de rijpe banaan en athem alsontbijt." (venster gecentreerd op "at")
- "Ik pelde de rijpe banaan en at hetals ontbijt." (venster gecentreerd op "het")
- ...
Een schuifvensteris een techniek die wordt gebruikt om de context van een woord in een tekstcorpus te bepalen. Een schuifvenster van grootte N is een venster dat over het tekstcorpus beweegt met een vaste stap van 1 woord per keer en met een grootte van N woorden. Als het tekstcorpus bijvoorbeeld "Ik heb de rijpe banaan gepeld en als ontbijt gegeten" is en we gebruiken een schuifvenster van grootte 5, dan wordt het venster eerst gecentreerd op de eerste 5 woorden van het tekstcorpus: "Ik heb de rijpe banaan gepeld". Daarna verplaatsen we het venster één woord naar rechts en centreren het op de volgende 5 woorden: "pelde de rijpe banaan en at". Dit proces gaat door totdat we het hele tekstcorpus hebben bestreken.
Voor elk woord in het schuifvenster worden de omringende woorden binnen het venster beschouwd als de context. Deze woorden worden gebruikt om een vectorrepresentatie te genereren voor het middelste woord in de woordinbedding.
Dus, als we bijvoorbeeld een schuifvenster van grootte 5 gebruiken op het tekstcorpus "Ik heb de rijpe banaan gepeld en als ontbijt gegeten" en het venster centreren op het woord "banaan", dan zijn de contextwoorden "ik", "gepeld", "de", "rijp" en "en". Deze woorden zouden worden gebruikt om de vectorrepresentatie voor het woord "banaan" te genereren in de woordinbedding.
Transformatoren en woordinsluitingen / Word2vec
Word2Vec richt zich op het leren van semantische relaties tussen woorden, terwijl een transformator, zoals BERT of GPT, contextuele representaties van woorden en hun relaties leert. Transformers zijn veelzijdiger en kunnen worden toegepast op een breed scala van NLP-taken.
NLP, of Natural Language Processing, is een technologie die computers helpt menselijke taal te begrijpen en ermee te werken. Het is alsof je computers leert praten zoals wij! Met NLP kunnen computers lezen, luisteren en begrijpen wat we zeggen of schrijven. Ze kunnen zelfs onze vragen beantwoorden of gesprekken met ons voeren. NLP wordt gebruikt in spraakassistenten (zoals Siri of Alexa), vertaal-apps en zelfs in sommige videogames. Het gaat erom computers slimmer te maken als het gaat om het begrijpen en gebruiken van taal, net als wij!