Supervised AI-algoritmes
Bekijk bovenstaande afbeelding op een aparte webpagina: https://www.leerschool.be/othercontent/aialgosen.php
Kies het juiste algoritme afhankelijk van het gewenste doel of de gewenste output
Afhankelijk van het "leerdoel" kies je als ontwikkelaar een supervised of unsupervised leermethode. Voor supervised kies je vervolgens het gewenste doel:
- classificatie: je wilt een categorie of klasse als output
- regressie: je wilt een getal of binaire waarde als uitvoer.
In de bovenstaande stamboom plaatsen we het "logistische regressie"-algoritme onder "regressie", maar heel vaak wordt het ook beschouwd als een "classificatie"-algoritme, omdat het net als een SVM slechts 2 waarden kan teruggeven: 0 of 1.
Bekijk eerst de film en maak dan de oefeningen
Selecteer het juiste algoritme: Maak de oefening
Welke variabelen heb je nodig? Maak de oefening
Supervised learning
1. Classificatie-algoritmen
Enkele van de bekendste classificatiealgoritmen zijn:.
- Naive Bayes
- Decision Tree
- Random Forest
- Support Vector Machines
- K-Neares Neighbors .
Naive Bayes
. Naive Bayesclassificeert gegevens door de statistische waarschijnlijkheid te schatten dat gegevens tot een bepaalde klasse of groep behoren. Het kijkt niet naar relaties, maar naar het aantal overeenkomsten en berekent op basis daarvan waarschijnlijkheden.
Beslissingsboom
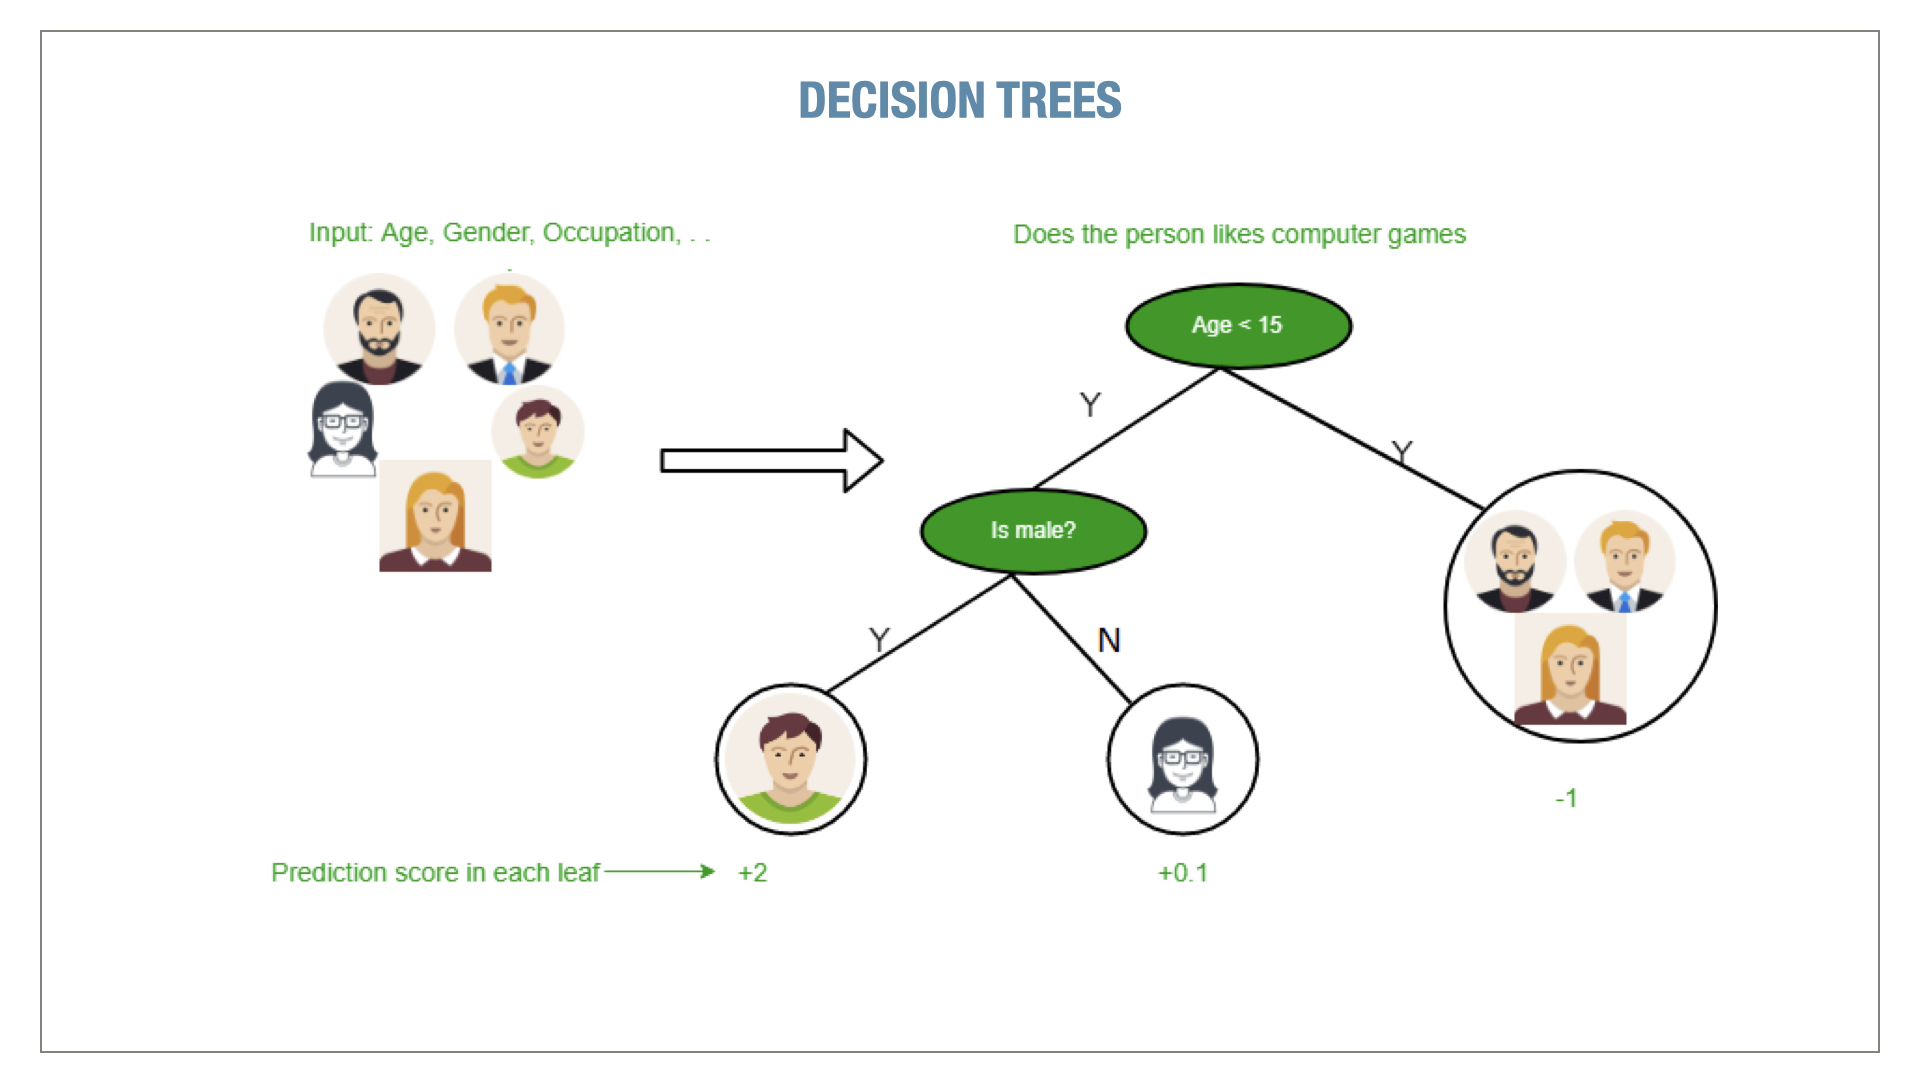
Decision Tree(beslisboom) heeft een stamboomachtige structuur. Bij elke 'tak' test je een bepaalde voorwaarde of eigenschap die de uitvoer naar de volgende tak bepaalt. Pas op: het kan leiden tot 'overfit' en de kleinste aanpassing aan de invoer (in dit geval trainingsgegevens), kan leiden tot drastische verschillen in de uitvoer.
Random forest
Random Forestis een verzameling beslisbomen waarbij elke beslisboom een deelverzameling van de gegevensattributen heeft gekregen en op basis van die deelverzameling voorspellingen doet. Het gemiddelde van de stemmen van alle beslisbomen leidt tot het antwoord. Dit algoritme vermindert het probleem van "overfitting" en leidt tot een veel nauwkeurigere classificatie.

Support vector machine
Een
Support Vector Machine(SVM)
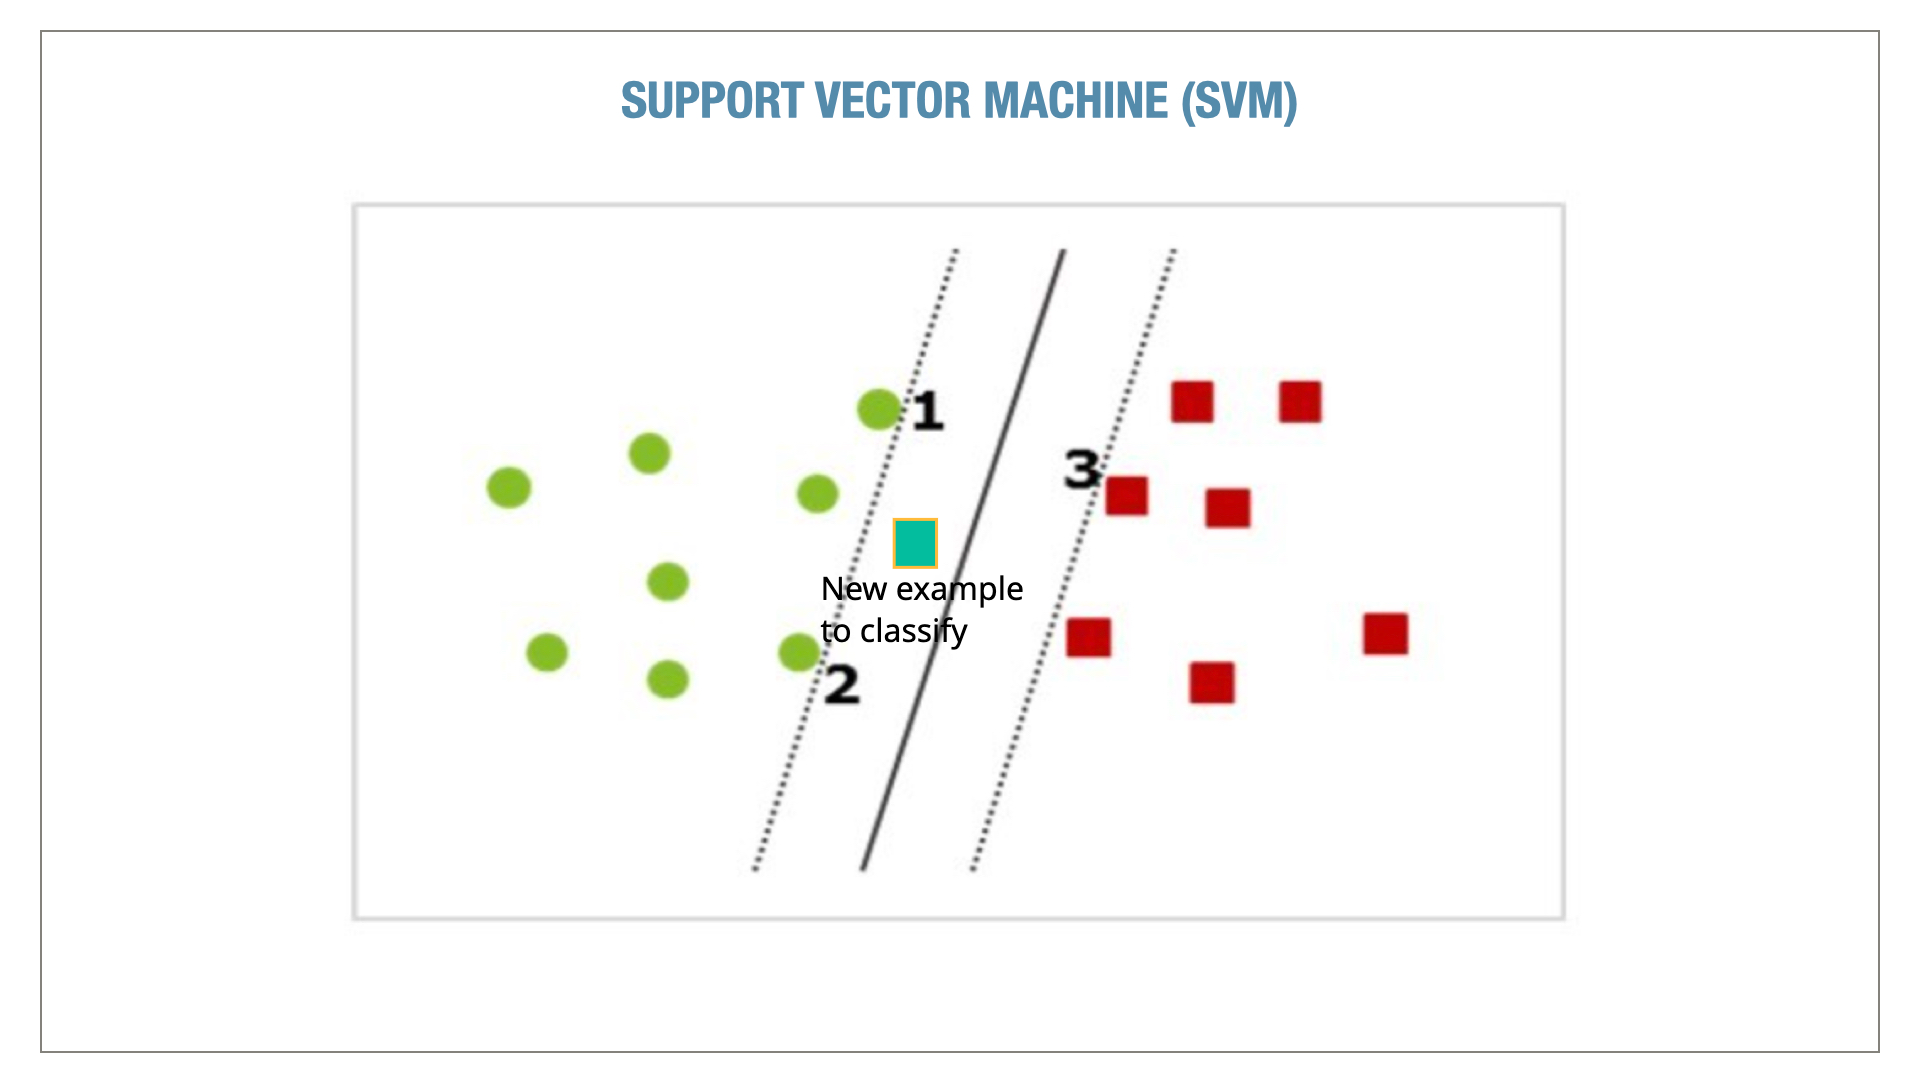
classificeert binair, het verdeelt de invoergegevens in twee klassenop basis van attributen die u vooraf hebt geselecteerd. Voordat de SVM dit kan doen, moet je het model trainen met historische gegevens. Het wordt een "vector" genoemd omdat elk gegevenspunt een x- en y-positie krijgt in een grafiek (of vectorruimte). SVM's werken goed voor kleine datasets die weinig ruis bevatten en vrijwel geen overlappende categorieën. SVM's zijn niet geschikt voor grotere datasets.
K-Nearest Neighbors
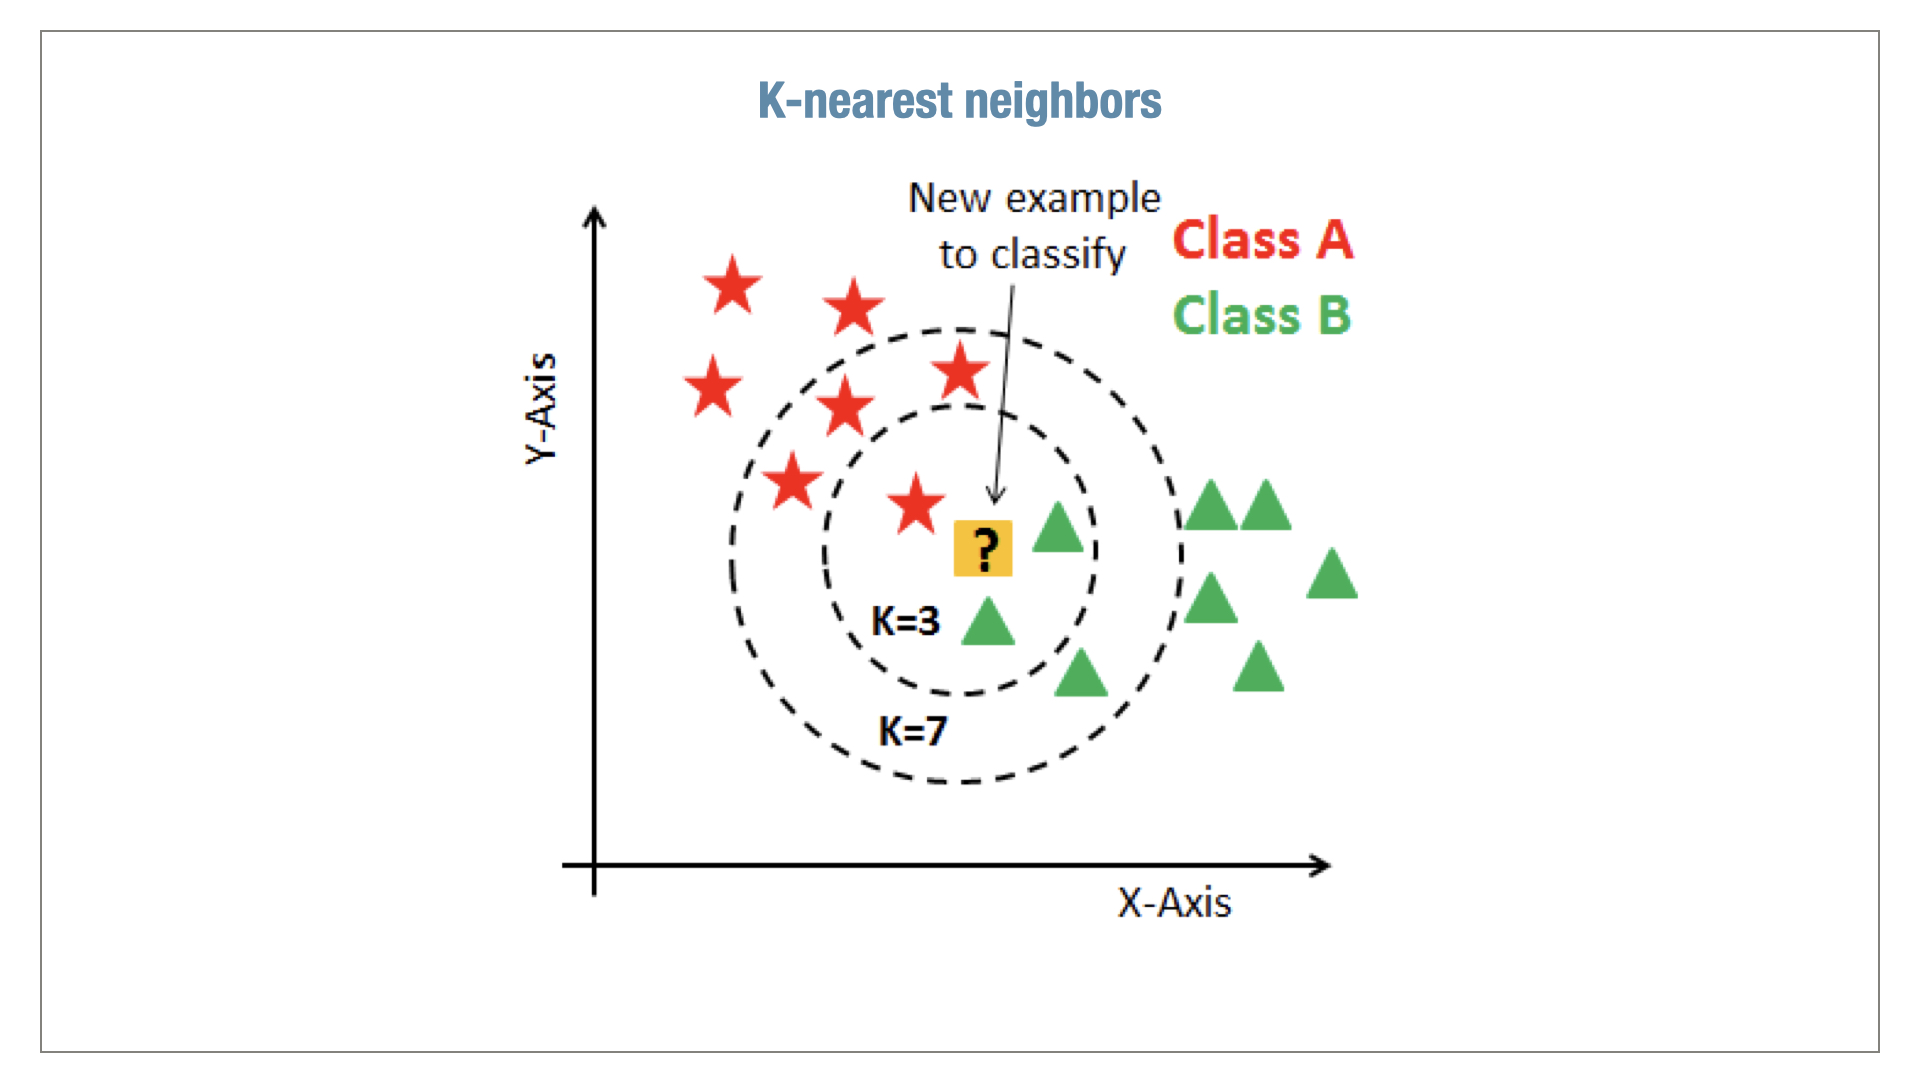
K-Nearest Neighbors (KNN)is gebaseerd op het idee dat de klasse waartoe een element behoort, overeenkomt met de klassen van de dichtstbijzijnde punten. Stel dat iedereen in je buurt "groen" kiest, dan is de kans groot dat jij dat ook doet. Bij K = 5 kijk je naar de vijf dichtstbijzijnde 'buren' (zij het in een vectorruimte). Bij K = 3 kijkt u naar de drie dichtstbijzijnde buren, enzovoort.
2. Regressiealgoritmen
In het kort: logistische regressievoorspelt in welke categorie gegevens vallen op basis van andere informatie. Bijvoorbeeld: op basis van eerdere resultaten van een student kun je voorspellen wat zijn waarschijnlijke eindresultaat zal zijn.
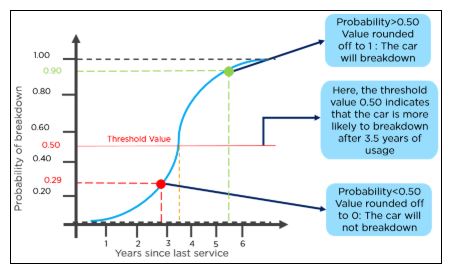
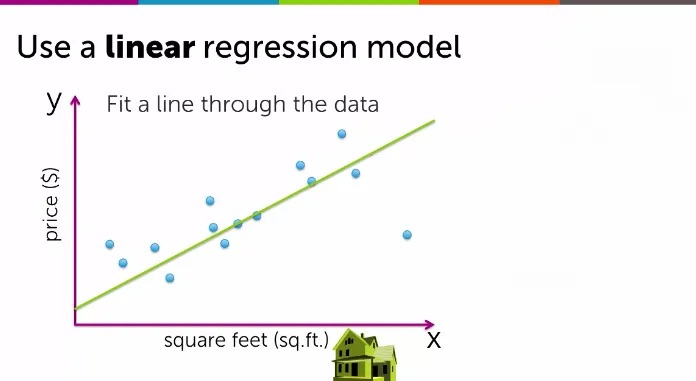
Lineaire regressieis het eenvoudigste en meest effectieve regressiealgoritme. Het wordt gebruikt om twee of meer variabelen (bijvoorbeeld de vraagprijs van een huis en de locatie) tegen elkaar af te wegen. Je kunt dit uitzetten in een grafiek en zo tot een regressielijn komen. Op basis van die lineaire regressie kun je prijzen voorspellen op basis van de locatie van een woning.
Maak de oefeningen
Welke variabelen heb je nodig bij deze problemen? Maak de oefening
Welk classificatie-algoritme heb je nodig? Maak de oefening