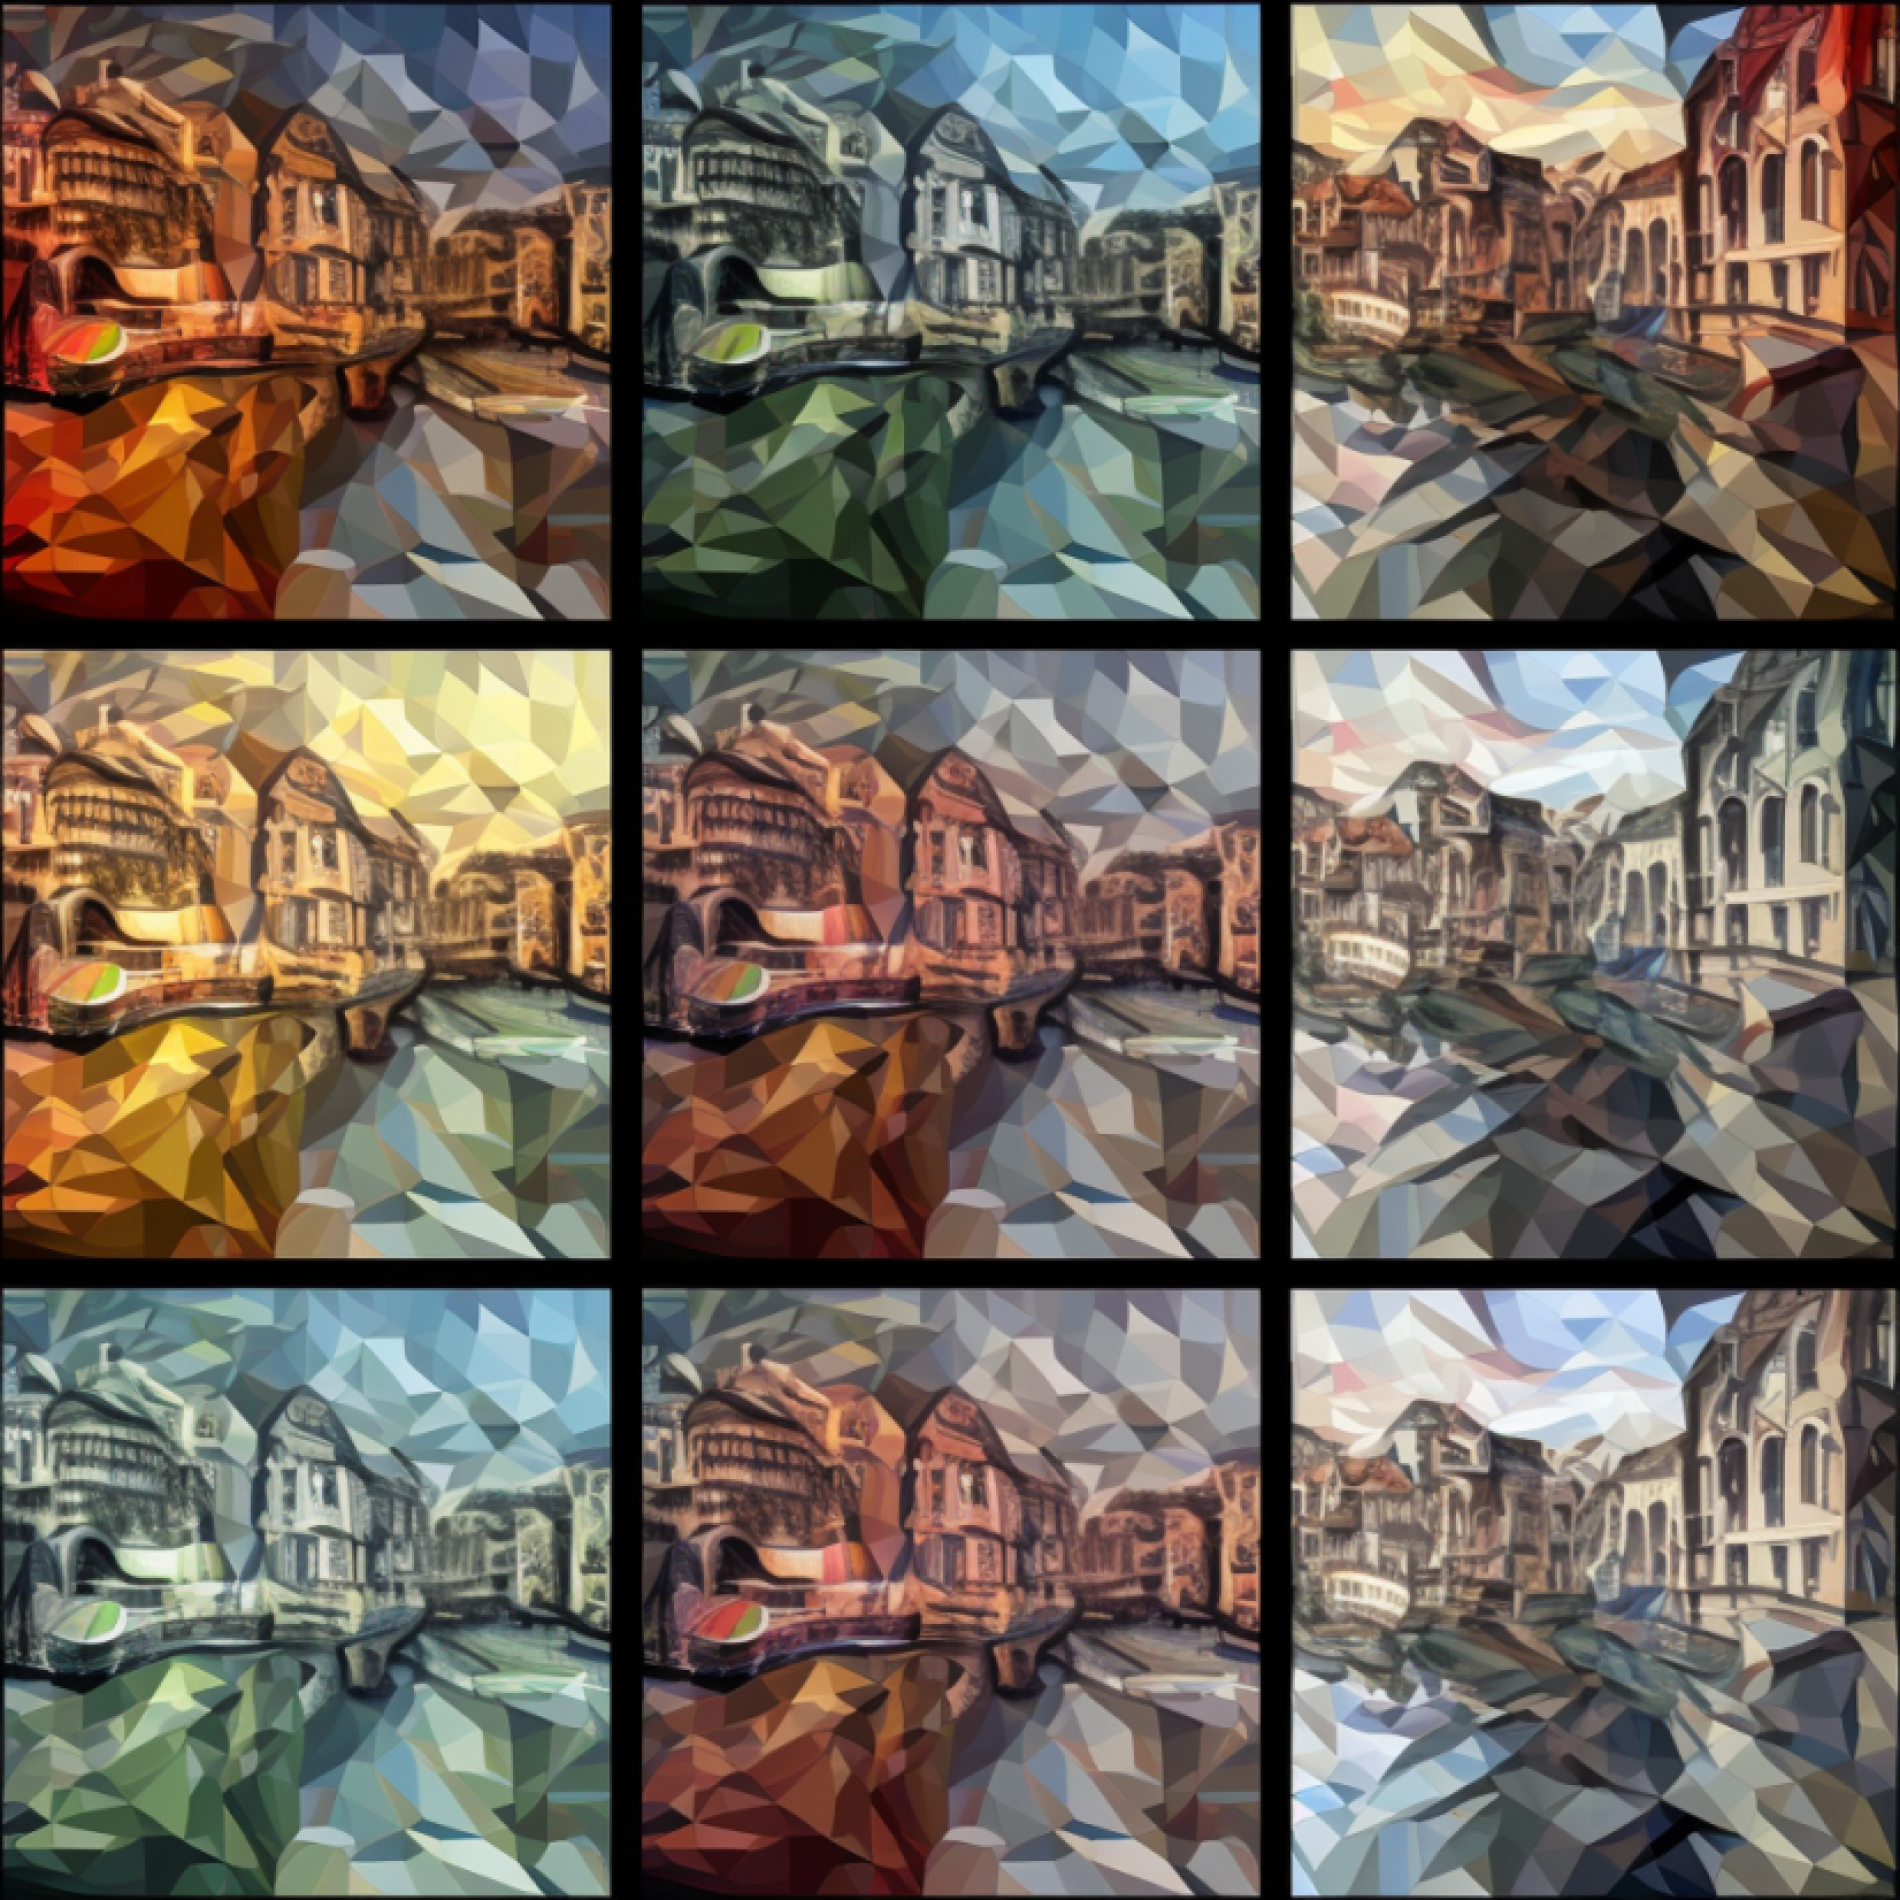
Generatieve AI en creatieve computers
Diffusiemodellen
Diffusiemodellen zijn geavanceerde algoritmes die beginnen met een basisafbeelding vol ruis en deze stap voor stap transformeren tot een duidelijke, complexe afbeelding. Ze voegen details toe en verfijnen het beeld, vergelijkbaar met hoe een kunstenaar een schilderij maakt. Dit proces maakt het mogelijk om fantastische en realistische beelden te creëren vanuit vrijwel enkel "ruis".
Een voorbeeld:
- Genereer een eenvoudige afbeelding van een vogel, die kan bestaan uit slechts een paar basisvormen of kleuren.
- Bedenk vervolgens hoe een iets complexere afbeelding van dezelfde vogel eruit zal zien. Het algoritme kan bijvoorbeeld kijken naar de kleur, texturen, randen, contouren van de huidige afbeelding en proberen te voorspellen hoe een iets completere of meer gedetailleerde afbeelding er waarschijnlijk uit zal zien.
- Voeg willekeurige ruis toe aan de huidige afbeelding, maar baseer het op de huidige afbeelding. Bijvoorbeeld: je maakt de randen iets subtieler, of je voegt hier en daar wat extra kleurvariaties toe. Met andere woorden: je voegt subtiele veranderingen toe aan de bestaande pixels.
- Herhaal de vorige twee stappen een aantal keer, waarbij je het niveau van complexiteit en detail in de afbeelding bij elke stap geleidelijk verhoogt (je verspreidt de hoeveelheid detail geleidelijk en "diffuus" over de hele afbeelding).
- Gebruik technieken zoals interpolatie of sampling om een eindafbeelding te genereren uit de reeks tussenbeelden die door het diffusiemodel zijn geproduceerd. Dit eindbeeld zal veel complexer en gedetailleerder zijn dan het oorspronkelijke eenvoudige beeld van de vogel.
Een AI die afbeeldingen genereert
Een café in Montreal, 2014. Een paar vrienden waren aan het praten terwijl ze bier dronken (heel belangrijk!) over hun werk op het gebied van AI. Je weet wel, mannen onder elkaar. Ze hadden het over het probleem dat deep learning weliswaar goed was in het classificeren van beelden, maar veel moeite had met het genereren van nieuwe beelden. Een van hen, Ian Goodfellow, kreeg de inspiratie om meerdere neurale netwerken elkaar te laten uitdagen om op die manier nieuwe inhoud te genereren. Je merkt het... bier kan helpen bij probleemoplossend denken ;-). Diezelfde avond schreef hij de benodigde code en testte deze met succes. Samen met zijn collega's aan de Universiteit van Montreal ontwikkelde hij het model verder en publiceerde er een paper over onder de naam "Generative Adversarial Nets". Het leverde Goodfellow een baan op bij Google Research en een positie bij OpenAI. GAN's leidden tot veel innovaties op het gebied van machinaal leren.
Generator en discriminator
Beeldclassificatie is vaak nog tijdrovend en duur. Stel dat je een diep neuraal netwerk wilt leren om katten te herkennen, dan moet je het eerst voeden met een massa foto's waarin de katten gelabeld zijn. Dat werk wordt door mensen gedaan. De AI kan steeds beter worden in het herkennen van katten in nieuwe afbeeldingen, maar vraag het niet om een "fictieve kat" te genereren. Een GAN combineert twee neurale netwerken. Het eerste genereert nieuwe gegevens (bijvoorbeeld een afbeelding van een kat). Het tweede netwerk is de discriminator, die werkt als een klassiek classificatienetwerk (denk aan een netwerk om katten te herkennen). De discriminator ontvangt de uitvoer van de generator en beoordeelt deze op een schaal tussen 0 en 1 (wat weinig lijkt, maar tel de komma's ertussen op). Als de score te laag is (zeg, tussen 0 en 0,5), corrigeert de generator de uitvoer en stuurt deze opnieuw naar de discriminator. Deze cyclus herhaalt zich supersnel in meerdere reeksen totdat het data produceert die overeenkomt met de gewenste uitvoer. Stel dat je een classificatienetwerk een serie schilderijen van Vincent Van Gogh voorlegt. Een mens labelt die van tevoren. Zo leert de AI het verschil tussen schilderijen die door Van Gogh zijn geschilderd en schilderijen die niet door Van Gogh zijn geschilderd. Vervolgens laat je een generator een nepschilderij van Van Gogh genereren, uiteraard niet met penseel en verf op doek, maar in "pixeldata". De generator gaat door totdat hij de discriminator kan vertellen dat het een authentiek schilderij van Van Gogh is.
GAN's hebben hun waarde al bewezen bij het maken en aanpassen van beelden. Ze kunnen fouten of ontbrekende gegevens in beelden herstellen, beelden of film inkleuren ... Maar er schuilt ook een gevaar in. Ze kunnen worden gebruikt om beelden en video's te manipuleren, denk maar aan "deep fake video". Voor de muziekindustrie genereren ze nieuwe composities in verschillende stijlen, die muzikanten kunnen aanpassen of corrigeren. Maar ze slagen er ook in om een film van een passende soundtrack te voorzien.
Het is niet zo moeilijk om de kracht van GANs in te schatten en nieuwe toepassingen te bedenken. Een robot of zelfrijdende auto kan GANs gebruiken om denkbeeldige werkomstandigheden te genereren en er doorheen te navigeren zonder dat hij hoeft te trainen op een echte werkvloer of in een echte omgeving.
Deep fake foto's en -films
Zo briljant en eenvoudig als het idee achter GAN's is, hebben ze wel enkele beperkingen. Ze vereisen nog steeds een overvloed aan trainingsgegevens. Als je bijvoorbeeld een "deep fake video" van Poetin wilt genereren, heb je nog steeds een massa bestaande videobeelden van deze president nodig. Als je niet genoeg historische gegevens hebt, zal de GAN geen solide eindresultaat kunnen produceren.
Generatieve AI in de praktijk
Creativiteit?
GAN's kunnen ook geen totaal nieuwe dingen uitvinden. Ze kunnen echter wel bestaande gegevens op nieuwe manieren combineren. Maar is dat niet precies hoe menselijke creativiteit ook werkt?
Sinds de zomer van 2022 groeide het succes van beeldgeneratoren zoals Dall-E ( https://openai.com/dall-e-2/), Midjourney ( https://midjourney.com/), Stable Diffusion. Het is ronduit verbazingwekkend waar deze generatoren al toe in staat zijn. Op basis van een eenvoudige tekst als "invoeropdracht" genereert de AI een gloednieuwe afbeelding. De weg ligt open voor generatoren die niet alleen stilstaande beelden genereren, maar ook animaties en film.
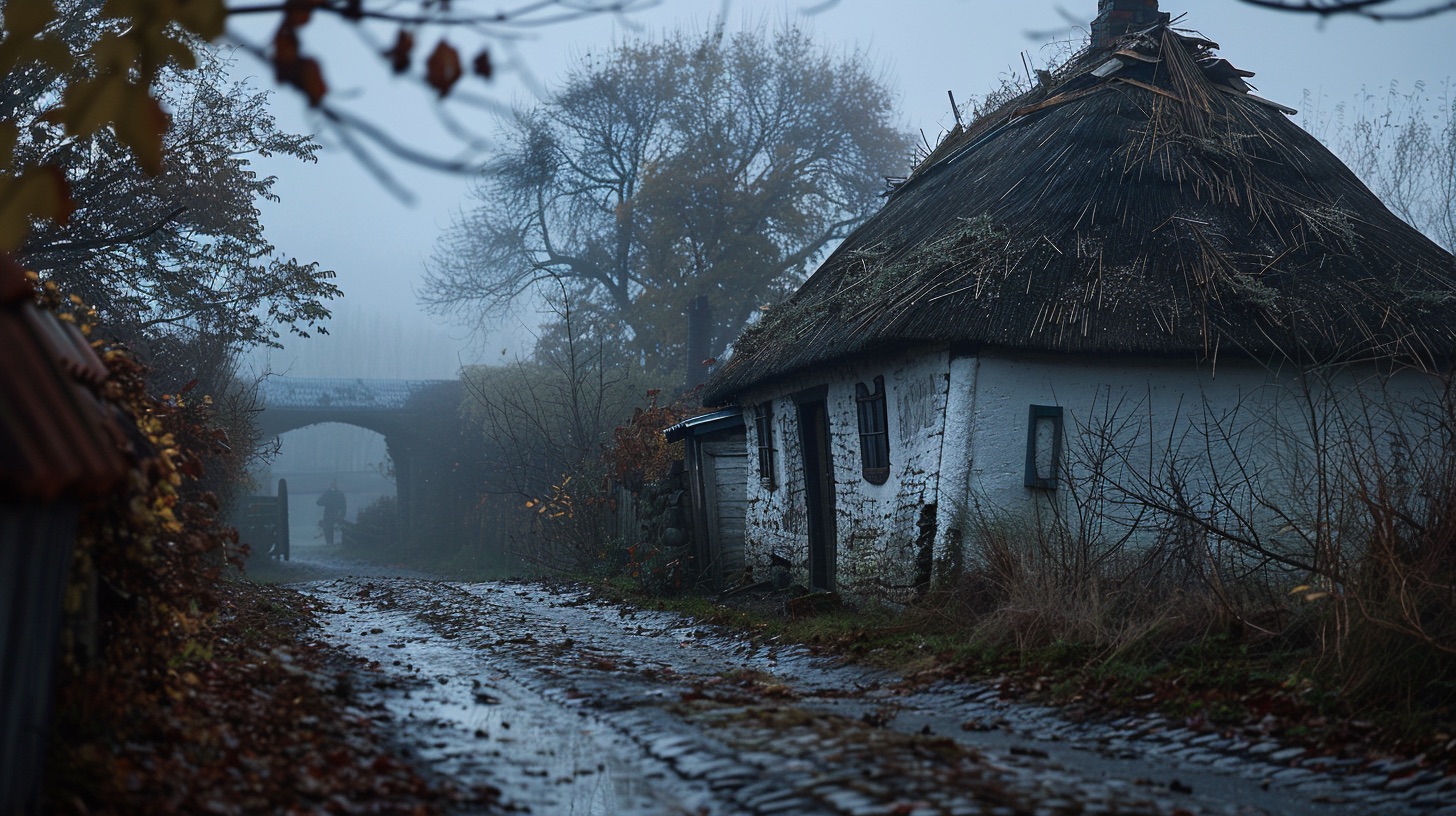
Verschillende resultaten met dezelfde prompt
Als je een afbeeldingsgenerator vraagt om een afbeelding te genereren op basis van een tekstaanvraag, kun je telkens andere resultaten krijgen, zelfs als je dezelfde aanvraag doet. Dit komt omdat de afbeeldingengenerator gebruik maakt van een proces dat stochasticiteitheet, wat betekent dat het willekeurigheid opneemt in zijn uitvoer.
In het bijzonder gebruikt de generator een willekeurige invoer (vaak een "latente vector" genoemd) om de afbeelding te genereren. Dit betekent dat zelfs als je dezelfde tekst prompt gebruikt, de random input die de generator gebruikt elke keer anders zal zijn, wat kan resulteren in verschillende outputs.
Extra is de generator getraind om afbeeldingen te maken die lijken op de afbeeldingen in de originele dataset, maar niet identiek zijn. Dit betekent dat zelfs als u dezelfde prompt gebruikt, de generator verschillende afbeeldingen kan genereren die nog steeds overeenkomen met de algemene kenmerken van de prompt.
Tot slot is het de moeite waard om op te merken dat het genereren van afbeeldingen met behulp van machine learning nog steeds een relatief nieuw en snel ontwikkelend gebied is, en dat de algoritmen die worden gebruikt door afbeeldingsgeneratoren nog niet perfect zijn. Er kan enige variabiliteit in de uitvoer zitten door onvolkomenheden in het algoritme of beperkingen in de trainingsgegevens.
Over het algemeen krijg je misschien verschillende resultaten elke keer dat je een afbeeldingengenerator gebruikt met dezelfde prompt, maar de generator zal nog steeds afbeeldingen maken die overeenkomen met de algemene kenmerken van de prompt en die vaak visueel interessant en creatief zijn.