Aanbevelingsmotoren
Evolutie van aanbevelingssystemen en gepersonaliseerde marketing
Aanbevelingssystemen zijn begin jaren '90 ontstaan als een manier om informatie te filteren en aan te bevelen op basis van gebruikersvoorkeuren. Aanvankelijk ontwikkeld in academische omgevingen, zijn deze systemen sindsdien essentiële hulpmiddelen geworden in digitale marketing en e-commerce.
1. Vroege collaboratieve filtering
Een van de eerste doorbraken kwam van het GroupLens Research Project aan de Universiteit van Minnesota in 1994. Onderzoekers zoals Paul Resnick en John Riedl ontwikkelden collaboratieve filtersystemen die nieuwsartikelen konden aanbevelen op basis van gebruikersbeoordelingen.
Lees meer over beoordelingssystemen: https://en.wikipedia.org/wiki/Rating_system
2. Commerciële adoptie
In 1995 bracht het Firefly-project collaboratieve filtering naar een commercieel publiek. Onder leiding van MIT-onderzoeker Pattie Maes stelde het gebruikers in staat muziek aan te bevelen op basis van vergelijkbare smaken. Dit markeerde het begin van het gebruik van aanbevelingssystemen voor marketingdoeleinden.
Lees meer over Firefly: https://en.wikipedia.org/wiki/Firefly_(website)
3. Amazon en schaalbare personalisatie
Aan het einde van de jaren '90 revolutioneerde Amazon het veld door item-naar-item collaboratieve filtering te introduceren. Deze benadering, ontwikkeld door Greg Linden en zijn team, stelde het platform in staat schaalbare en realtime productaanbevelingen te bieden, waardoor de winkelervaring voor miljoenen gebruikers werd gepersonaliseerd.
Lees meer over het aanbevelingsalgoritme van Amazon: https://www.amazon.science/the-history-of-amazons-recommendation-algorithm
4. Van aanbevelingen naar gepersonaliseerde marketing
Tegenwoordig staan aanbevelingssystemen centraal in strategieën voor gepersonaliseerde marketing. Door het analyseren van gebruikersgedrag, aankoopgeschiedenis en voorkeuren leveren bedrijven op maat gemaakte content, e-mails en productaanbevelingen. Deze evolutie heeft de manier waarop merken verbinding maken met consumenten getransformeerd, waardoor marketing relevanter en data-gedreven is geworden.
a. Numeriek
Een "numerieke top 10" van de meest verkochte producten zou een lijst kunnen zijn van de top 10 producten gerangschikt volgens het aantal verkochte eenheden, met het product dat het meest verkocht bovenaan de lijst en het product dat het 10e meest verkocht onderaan de lijst. Op dezelfde manier zou een "numerieke top 5" van de meest bekeken films een lijst van de top 5 films kunnen zijn, gerangschikt op basis van het aantal weergaven, met de film die het meest werd bekeken bovenaan de lijst en de film die het 5e meest werd bekeken onderaan de lijst.
Numerieke toppen kunnen nuttig zijn voor verschillende toepassingen, zoals het identificeren van populaire producten, het benadrukken van trends of patronen of het doen van aanbevelingen op basis van de populairste items. Maar ze hebben ook veel nadelen:
- Iedereen krijgt dezelfde lijst
- Houdt geen rekening met individuele gebruikersvoorkeuren
- Goed verkopende producten verkopen nog meer
- De niche krijgt weinig kansen
Een aanbevelingsmachine biedt een goede oplossing om deze nadelen weg te nemen
Een aanbevelingsmachine, ook bekend als een aanbevelingssysteem, is een AI-algoritme dat gebruikers suggesties doet op basis van hun interesses en voorkeuren. Deze items kunnen van alles zijn, van producten op een e-commercesite tot films op een streamingdienst.
De aanbevelingsengine werkt door gegevens over het gedrag en de interacties van de gebruiker met het systeem te analyseren. Deze gegevens kunnen de items omvatten die ze in het verleden hebben bekeken of gekocht, evenals beoordelingen of recensies die ze hebben gegeven.
Met behulp van deze gegevens bouwt de aanbevelingsmachine een model op van de voorkeuren en interesses van de gebruiker. Vervolgens gebruikt het dit model om nieuwe items voor te stellen waarin de gebruiker waarschijnlijk geïnteresseerd is. De suggesties kunnen gebaseerd zijn op factoren zoals gelijkenis met eerder bekeken items, populariteit onder gelijkaardige gebruikers of andere relevante kenmerken.
Ben je bijvoorbeeld aan het rondkijken in een online boekwinkel en heb je in het verleden verschillende sciencefictionromans gekocht. Een aanbevelingsmachine zou deze informatie kunnen gebruiken om nieuwe sciencefictionromans voor te stellen die u nog niet hebt gelezen, op basis van uw gedrag in het verleden en het gedrag van vergelijkbare gebruikers.
Aanbevelingsmachines kunnen zeer nuttig zijn voor zowel gebruikers als bedrijven. Gebruikers profiteren van gepersonaliseerde aanbevelingen die hen helpen nieuwe en interessante items te ontdekken, terwijl bedrijven profiteren van een grotere betrokkenheid en verkoop.
Er zijn verschillende soorten aanbevelingsmachines, waaronder collaborative filtering, content-based filtering, en hybridbenaderingen die beide methoden combineren. Elk type heeft zijn eigen sterke en zwakke punten, en de keuze van welk type te gebruiken hangt af van het specifieke gebruik en de beschikbare gegevens.
Samenwerkend filteren en filteren op inhoud zijn twee verschillende benaderingen voor het bouwen van aanbevelingsmachines.
b. Collaborative filtering - gebruikers vergelijken
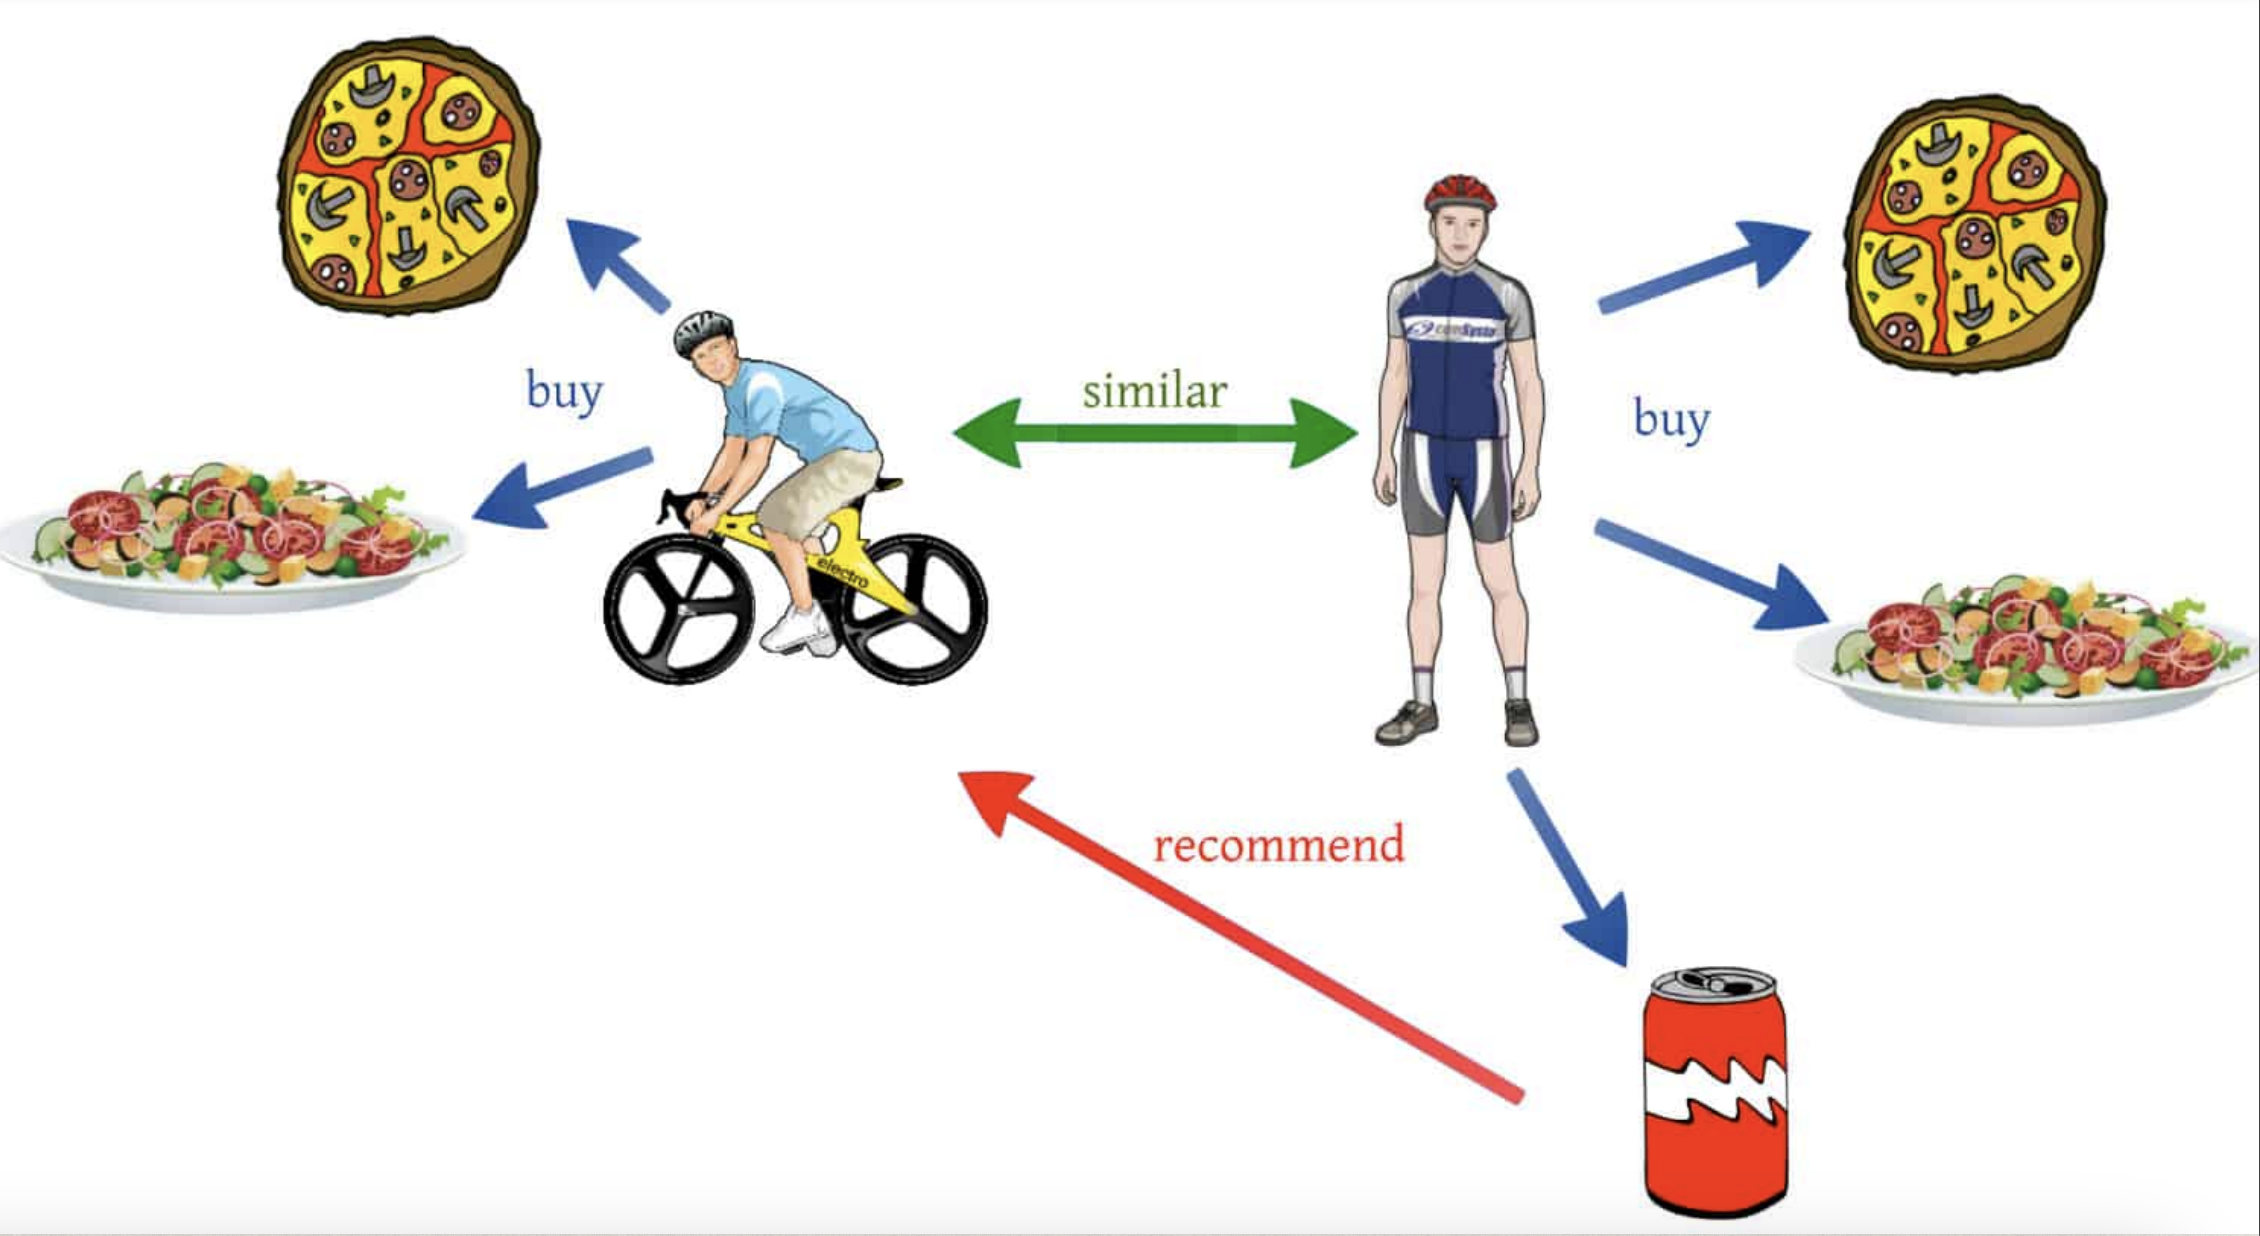
Samenwerkingsfiltering is gebaseerd op het idee dat mensen die in het verleden dezelfde interesses of hetzelfde gedrag hebben gehad, in de toekomst waarschijnlijk ook dezelfde interesses of hetzelfde gedrag zullen vertonen. Collaborative filtering gebruikt gegevens over de interacties van gebruikers met het systeem, zoals hun beoordelingen, recensies of aankoopgeschiedenis, om overeenkomsten tussen gebruikers te vinden en items aan te bevelen die soortgelijke gebruikers in het verleden leuk vonden.
Ben je bijvoorbeeld aan het surfen op een streamingdienst en heb je in het verleden verschillende actiefilms bekeken. Een aanbevelingsmachine met collaboratieve filtering zou deze informatie kunnen gebruiken om andere actiefilms aan te bevelen die andere gebruikers met een vergelijkbare kijkgeschiedenis hebben bekeken.
Collaboratieve filtering met klantgegevens
Collaboratieve filtering is gebaseerd op het idee dat mensen die in het verleden vergelijkbare dingen leuk vonden, in de toekomst vergelijkbare dingen leuk zullen vinden. Om dit te laten werken, volg je wat gebruikers doen: wat ze kopen, kijken, beoordelen of waarop ze klikken.
Bijvoorbeeld, als Alice en Bob allebei dezelfde drie shows bekeken, en Alice een vierde show bekeek die Bob nog niet heeft gezien, zou het systeem die vierde show aan Bob kunnen aanbevelen — simpelweg omdat Alice en Bob een vergelijkbare smaak hebben.
Om deze vergelijkingen te maken, bekijkt het systeem grote tabellen met gebruikersgedrag en vindt mensen of items die vaak samen voorkomen. Het hoeft niet te begrijpen wat de items zijn — alleen hoe mensen ermee omgaan.
c. Content based filtering - inhoud vergelijken
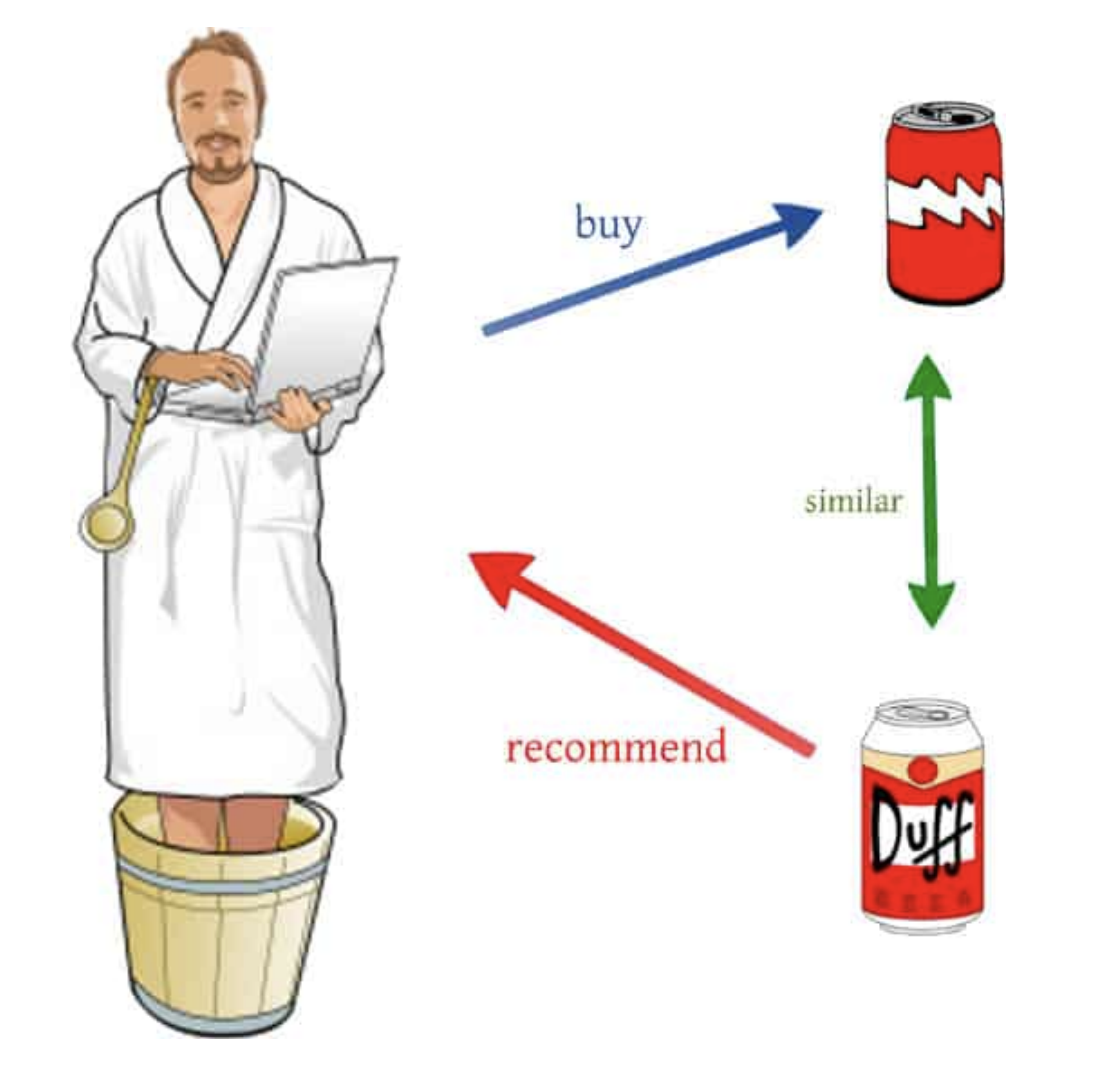
Op inhoud gebaseerde filtering daarentegen richt zich op de eigenschappen van items zelf om aanbevelingen te doen. Het gebruikt gegevens over de inhoud of kenmerken van items, zoals genre, plot of stijl, om gebruikers gelijksoortige items aan te bevelen.
Ben je bijvoorbeeld aan het rondkijken in een online boekwinkel en heb je in het verleden verschillende romans gekocht. Een filtergebaseerde aanbevelingsmachine zou deze informatie kunnen gebruiken om andere romans aan te bevelen met vergelijkbare thema's, settings of schrijfstijlen.
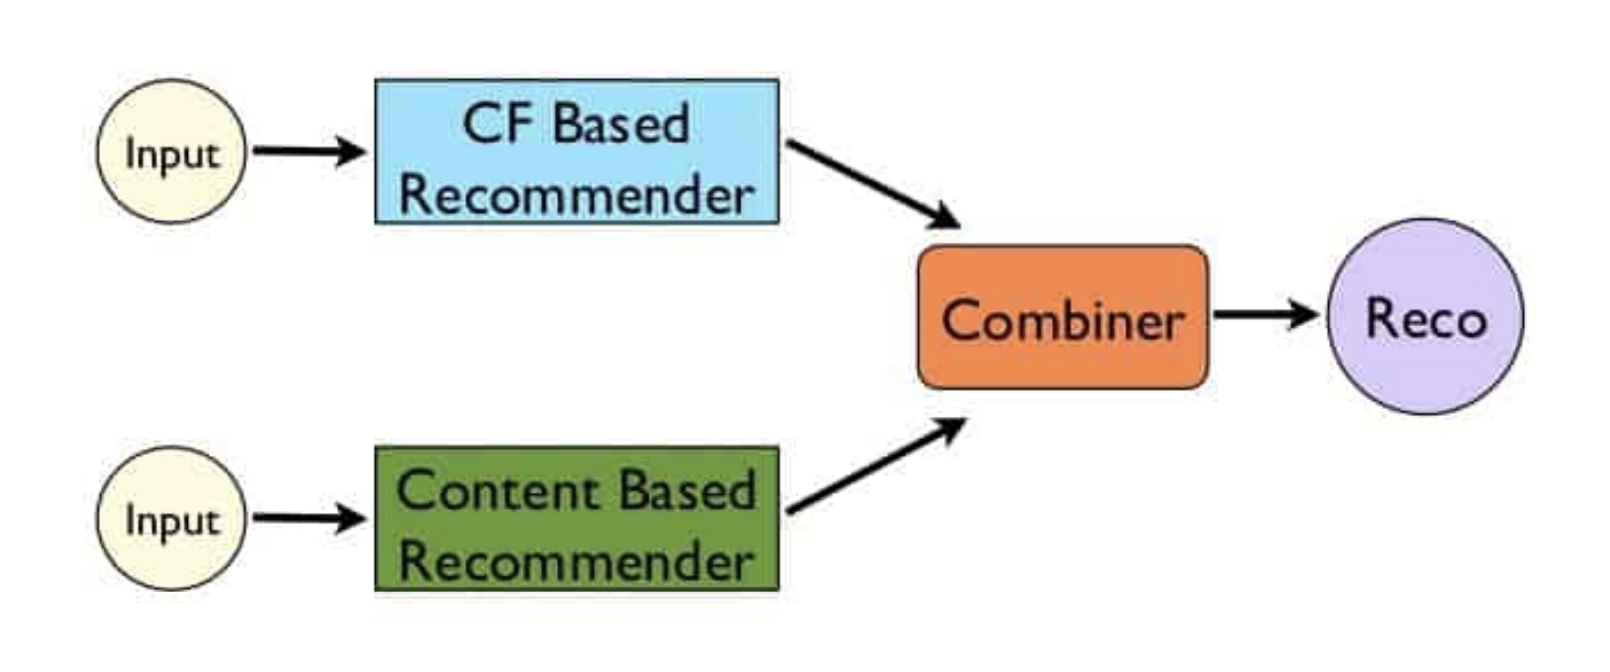
Samenwerkend filteren en filteren op inhoud hebben beide hun sterke en zwakke punten, en de keuze voor een van de twee hangt af van het specifieke gebruik en de beschikbare gegevens. Hybride benaderingen die beide methoden combineren kunnen ook effectief zijn in bepaalde situaties.
Content-gebaseerde filtering met productgegevens
Content-gebaseerde filtering kijkt niet naar andere gebruikers — het kijkt naar het product zelf. Elk item wordt beschreven met kenmerken zoals genre, acteurs, trefwoorden, merk of technische specificaties.
Bijvoorbeeld, als je veel sciencefictionfilms kijkt die ruimte en robots bevatten, zal het systeem zoeken naar andere films met dezelfde kenmerken en deze aanbevelen — zelfs als niemand anders ze nog heeft bekeken.
Wanneer productomschrijvingen in tekst staan (zoals een filmplot of een productbeschrijving), kan het systeem de gebruikte woorden analyseren en vergelijken met andere omschrijvingen. Hoe meer woorden of categorieën twee items gemeen hebben, hoe meer ze op elkaar lijken.
Gebruik van TF-IDF voor content-gebaseerde filtering
TF-IDF staat voor "Term Frequency – Inverse Document Frequency". Het is een methode om te begrijpen welke woorden belangrijk zijn in een productbeschrijving of document.
In content-gebaseerde filtering helpt TF-IDF om productbeschrijvingen om te zetten in cijfers, zodat het systeem ze kan vergelijken. Bijvoorbeeld, als twee films vaak "ruimte", "toekomst" en "robot" vermelden, zijn ze waarschijnlijk vergelijkbaar.
TF (Term Frequency) telt hoe vaak een woord voorkomt in een beschrijving. IDF (Inverse Document Frequency) vermindert het gewicht van veelvoorkomende woorden zoals "de" of "en", en verhoogt het gewicht van zeldzame maar betekenisvolle woorden.
Door TF en IDF te combineren, creëert het systeem een lijst van gewogen trefwoorden voor elk product. Vervolgens vergelijkt het deze lijsten om items te vinden die qua betekenis op elkaar lijken, zelfs als de exacte woorden verschillen.
Dit is nuttig voor het vinden van gerelateerde producten, artikelen of media — puur op basis van hun inhoud, zonder dat gebruikersgedrag nodig is.
d. Hybride filteren
Hybride filtering is een combinatie van collaboratief filteren en filteren op basis van inhoud.
Voordelen van een aanbevelingsmachine
- Iedereen krijgt aangepaste suggesties
- Houdt rekening met individuele gebruikersvoorkeuren
- Mensen leren dingen kennen die ze anders nooit te weten komen
- De niche krijgt veel meer kansen
Nadelen
Aanbevelingsmachines kunnen gebruikers ook keuzestress bezorgen. Het aanbod van alternatieve suggesties kan zo groot zijn dat je als gebruiker niet meer weet wat te kiezen.