Leermethodes
Algoritmen
Computers volgen stappen(algoritmen) om invoer te verwerken tot de gewenste uitvoer. Hoe slim die stappenplannen soms ook zijn, ze kunnen nog steeds niet tippen aan de menselijke intelligentie. Bovendien zijn al die algoritmes in eerste instantie door mensen bedacht. In feite slagen computers er nog niet in om alle stappen zelf te bedenken of om tot de best mogelijke oplossing voor problemen te komen. Mensen kunnen dat wel. Ook al maak je in je leven heel wat verkeerde keuzes, in veel gevallen leer je van je fouten. Natuurlijk leren we niet alles door eerst fouten te maken. De meeste kennis en vaardigheden leren we door ervaring of door naar voorbeelden te kijken. Herhaling helpt daarbij, dat weten we allemaal.
Machine learning
Kunstmatige intelligentie betekent dat computersystemen uit zichzelf leren om tot oplossingen te komen. We programmeren software om zelf te leren door ervaring of door voorbeelden, net zoals mensen en zelfs dieren dat doen. Computerwetenschappers gebruiken verschillende lerende algoritmenom dit te doen. Ze proberen bijvoorbeeld de werking van neuronen in het menselijk brein te simuleren met software. We spreken in dit geval van een "neuraal netwerk". De meeste dingen in ons leven leren we ook door voorbeelden van anderen. Zelfs op school moeten we leren van voorbeelden en fouten.
- Online/batch learning (=continu leren....)
- Supervised learning (leren onder toezicht)
- Unsupervised learning (leren zonder toezicht)
- Reinforcement learning
- Hybride leren
Gecontroleerd leren
Stel je hebt een kat en je zegt steeds tegen je zoontje van twee: "Dit is de kat. Je zoontje heeft echter nog nooit een hond gezien. De kans is groot dat hij bij zijn eerste ontmoeting met een hond zal zeggen: "Kijk mama, een kat! Dan zeg jij: "Echt niet, dat is een hond. Door dit een paar keer te herhalen, zal je zoontje snel het verschil leren tussen een hond en een kat. Geleidelijk aan zal hij leren onderscheid te maken tussen de twee en dan ook begrijpen dat de schapen van de buren geen honden of katten zijn. Kinderen (zelfs op school) leren door 'begeleid leren', of leren onder toezicht. Ze leren van hun fouten en van voorbeelden omdat iemand ze aanwijst. Door neurale netwerken in software te programmeren, kunnen computers zelf leren ('machine learning').
We voeden de AI-software eerst met trainingssets (of datasets ). Dit kan bijvoorbeeld een reeks foto's van honden zijn. Door een massa foto's van honden als trainingssets aan de software te voeren, leert het neurale netwerk geleidelijk zelf honden in andere foto's te herkennen. Een belangrijk verschil is dat een mens minder voorbeelden nodig heeft dan een AI-algoritme. Een kind dat een paar keer een kat heeft gezien, zal ook snel andere katten herkennen.
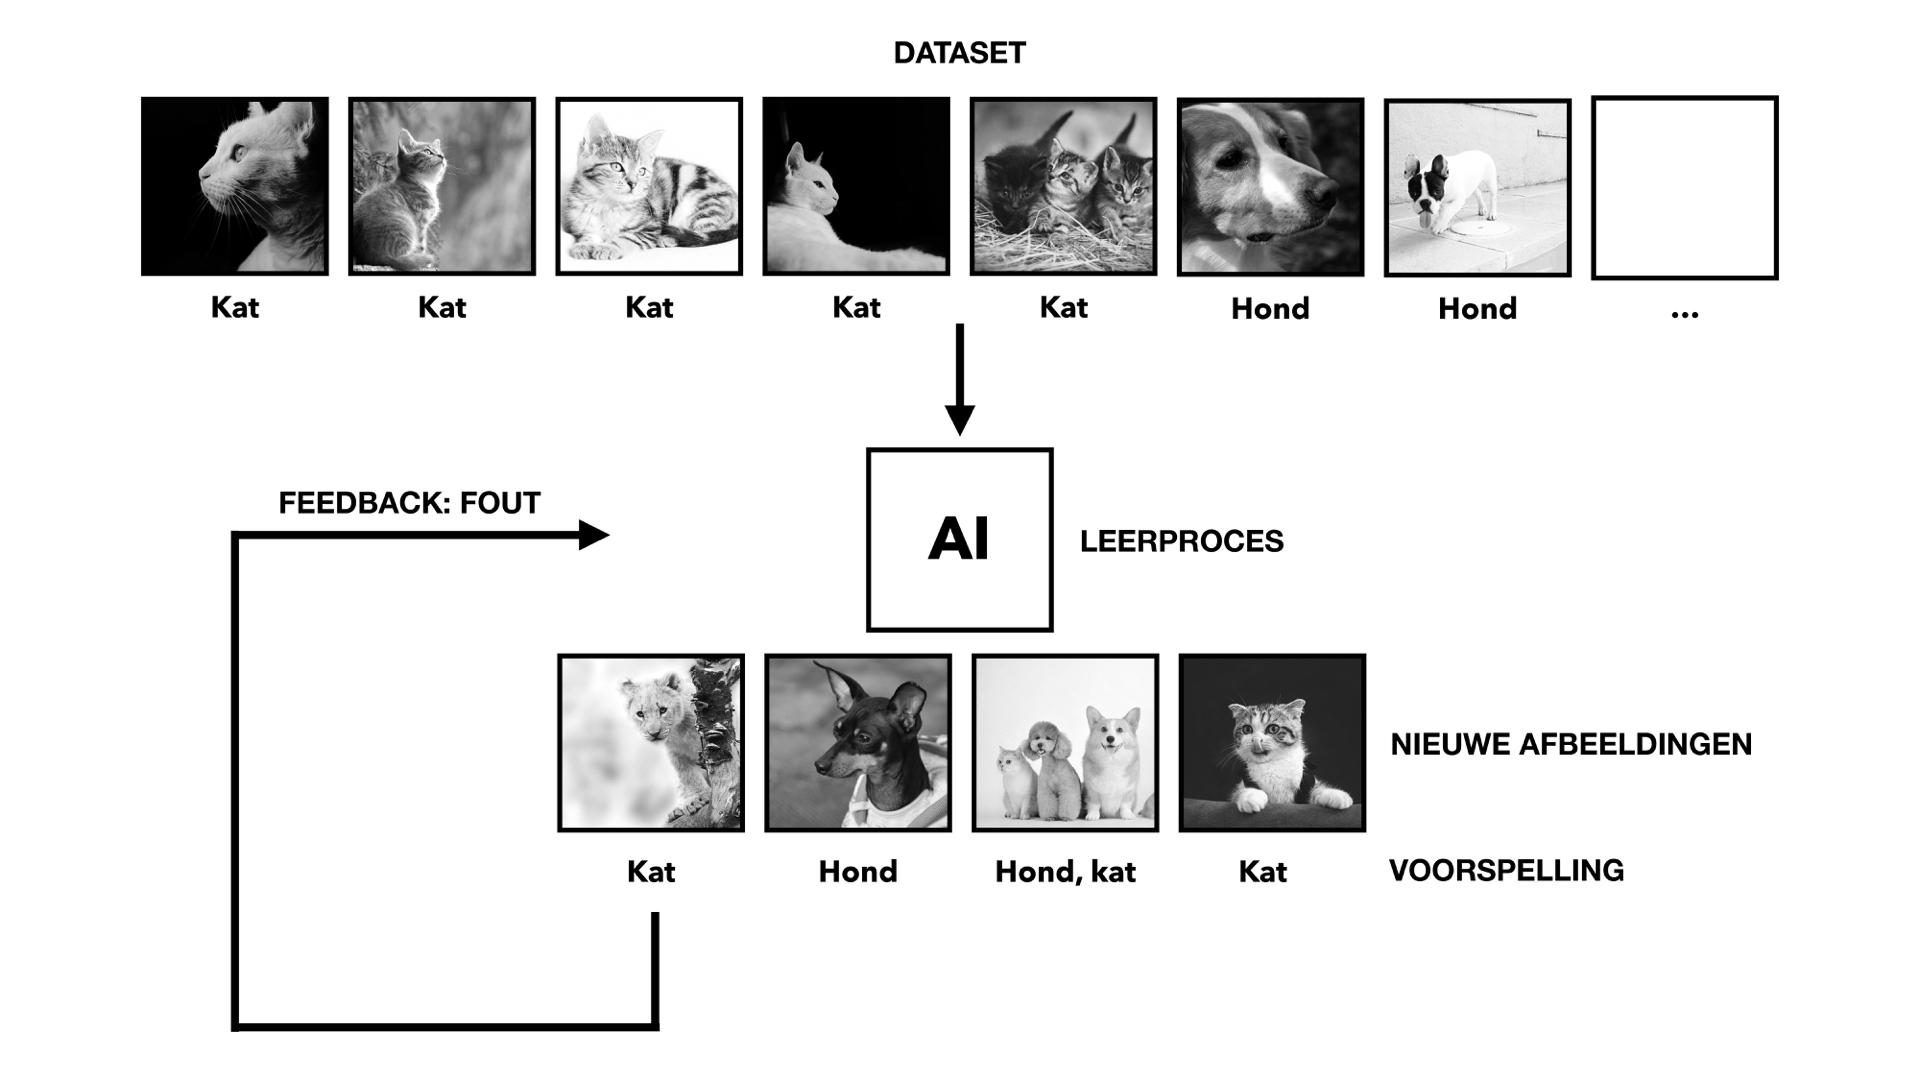
AI heeft een massa voorbeelden nodig.Een kat kan er immers heel verschillend uitzien, want er zijn bijvoorbeeld tientallen rassen. Daarnaast moet je een kat ook vanuit alle mogelijke "hoeken" (bovenaanzicht, achteraanzicht...) en tussen andere objecten in een afbeelding kunnen herkennen. Hiervoor moet een AI ook verschillende objecten kunnen segmenteren of van elkaar onderscheiden. Immers, als je een afbeelding of webcambeeld aan een AI laat zien, bestaat die inputdata alleen uit een reeks pixels met RGB-kleurwaarden. De AI moet dus op zoek naar patronen in pixeldata.
Reinforcement learning
Bij 'begeleid leren' leert het algoritme van voorbeelden. Bij versterkend leren versterk je het algoritme door het te belonen of te straffen. Als de voorspelde output verkeerd of onvolledig is of tot een verkeerd resultaat leidt, kan de AI-software 'leren' van zijn eigen fouten. Stel dat een robot rondrijdt in een kamer die maar één uitgang heeft, dan kan die robot proberen om eruit te komen door willekeurig tegen de muur te botsen totdat hij de opening vindt. Maar als de robot eenmaal de deur heeft ontdekt, dan kan hij deze 'onthouden'.
Unsupervised learning
In unsupervised learningkrijgt het algoritme geen voorbeelden, maar moet het zelf elementen classificeren (categoriseren) op basis van gemeenschappelijke kenmerken. Bij unsupervised learning krijgt het algoritme vooraf geen voorbeelden of labels. Het algoritme moet de informatie zelf classificeren op basis van kenmerken. Stel dat je voor het eerst in je leven de was moet doen. Je ziet een stapel ongewassen kleren voor je. Nu moet je de was classificeren op basis van een aantal kenmerken. Classificeren op kleur en textielsoort zou de gewenste output zijn. Maar dat is wat het "algoritme" nu moet ontdekken. Als je het K-means algoritme gebruikt, kun je alleen van tevoren aangeven hoeveel groepen je wilt. De rest moet het algoritme zelf ontdekken.
