Gestructureerde en ongestructureerde data
Het verschil tussen ongestructureerde en gestructureerde data
- Wat is het verschil tussen gestructureerde en ongestructureerde data?
- Hoe kan je data structureren?
- Wanneer zijn data semantisch?
De meeste data en bestanden bevatten voor computers enigszins ongestructureerde data. Dat klinkt vreemd als je beseft dat de digitale data nu eenmaal voor en door computers zijn opgesteld. Dit betekent echter nog niet dat de computer ook de inhoud van die data snapt.
Een foto bijvoorbeeld wordt door een computer opgebouwd door een raster van kolommen en rijen te vullen met kleurinformatie. Een pixel (picture element) is een vakje in zo’n raster en bevat voor een computer drie cijfergegevens: een kleurwaarde voor rood, een waarde voor groen en een waarde voor blauw. Een computer zal daarnaast aan elke pixel een x- en y-positie in het raster toekennen en onthoudt aldus voor die pixel vijf cijfergegevens. Dat is dus in zekere zin gestructureerd, maar dat vertelt nog niets over de inhoud van de afbeelding. Staat er een koe, een appel of een flesje bier op de foto? Dat vertellen de data niet in dit geval. Je zou die informatie kunnen toevoegen waardoor de “afbeeldingsbron” niet meer enkel pixelwaarden en posities bevat, maar ook “labels”.
Ook voor teksten is dit het geval. Elke letter in een tekst wordt bewaard als een cijfercode, maar de computer weet niets over de inhoud van de tekst
Wat kan een computer "herkennen"?
Binair gecodeerde bestanden zijn voor een computersysteem moeilijker te "herkennen" (of "begrijpen") dan tekstbestanden (=ASCII, UTF-8...). Een tekstbestand bevat immers enkel "tekst" die je ook met een standaard toetsenbord kan intikken. Je kan een stuk software dus vertellen om enkel naar de "tekst" te kijken. ASCII/UTF-8-tekstbestanden zijn door elk computersysteem te lezen. Je hebt er niet speciale software voor nodig om de binaire codes te decoderen.
Je kan software wel "leren" om in tekstbestanden bepaalde patronen herkennen:
- regeleindes: harde returns
- leestekens: laten kijken naar herhalende patronen van komma's, dubbele punten, aanhalingstekens
- bepaalde repeterende patronen of markeringen in tekstvorm
- "afgesproken" tekens of sleutelwoorden
- akkolades en haakjes
- tabs
Soms zijn meerdere van bovenstaande herkenningspatronen aanwezig in één bestand. Maar ze zijn niet altijd "relevant" voor de computer zelf. Regeleindes of tabs worden in code vaak ook gebruikt om de code of de data "'leesbaar" te houden voor mensen. In de voorbeelden onderaan deze les moet je kijken naar welke herkenningspatronen relevant zijn voor de software zelf.
Gestructureerde data
Wat bedoelen we dan eigenlijk met gestructureerde gegevens? Het gaat om
- gegevens met heldere patronen die een machine/ computer makkelijk kan herkennen.
Bijvoorbeeld: een lijst met rijen en kolommen, creditcardnummers, postcodes, - gestructureerde mededelingen op overschrijvingen…
Bijvoorbeeld: gegevens met sleutel en waarde-paren. - gegevens met sleutel en waarde-paren.
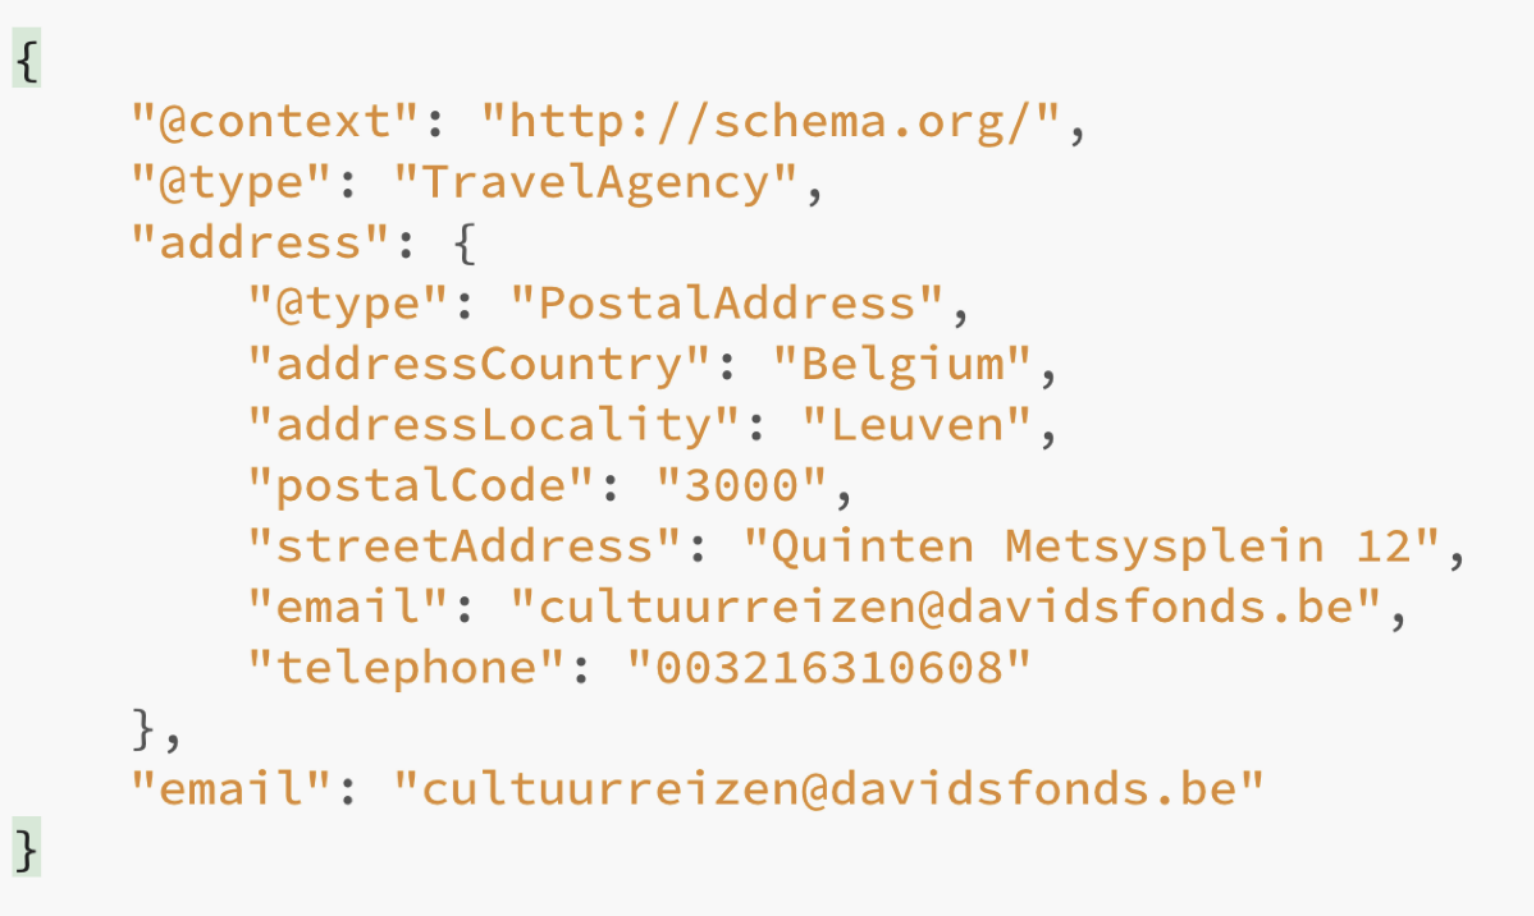
Bijvoorbeeldeen JSON-bestand.
Ongestructureerde data
Ongestructureerde data bieden weinig of geen houvast over de inhoud van de data of de “semantiek”.
- Gegevens die niet in een tabel staan met een herkenbaar aantal rijen en kolommen of sleutels met hun waarde.
Bijvoorbeeld: tekstdocumenten, webpagina’s, presentaties…
- Gegevens met minder heldere patronen voor computersystemen (dat wil niet zeggen dat er helemaal geen patronen in zitten)
Bijvoorbeeld: Afbeeldingen, audio, video…
Types gestructureerde data
Doorheen de tijd hebben zich een aantal standaarden ontwikkeld voor het structureren van tekstdata.
- Markeertalenzoals HTML(hypertext markup language) en XML(extensible markup language) markeren elementen in een tekstbestand door aan te duiden waar een onderdeel begint en waar één eindigt. Je markeert op die manier de diverse onderdelen van je data. Op die manier kan software sneller terugvinden waar een bepaald element staat.
- Je kan tekstdata ook scheiden met leestekens, spaties of tabs. Een CSV-bestand scheidt rijen met regeleindes (harde returns), kolommen met een komma.
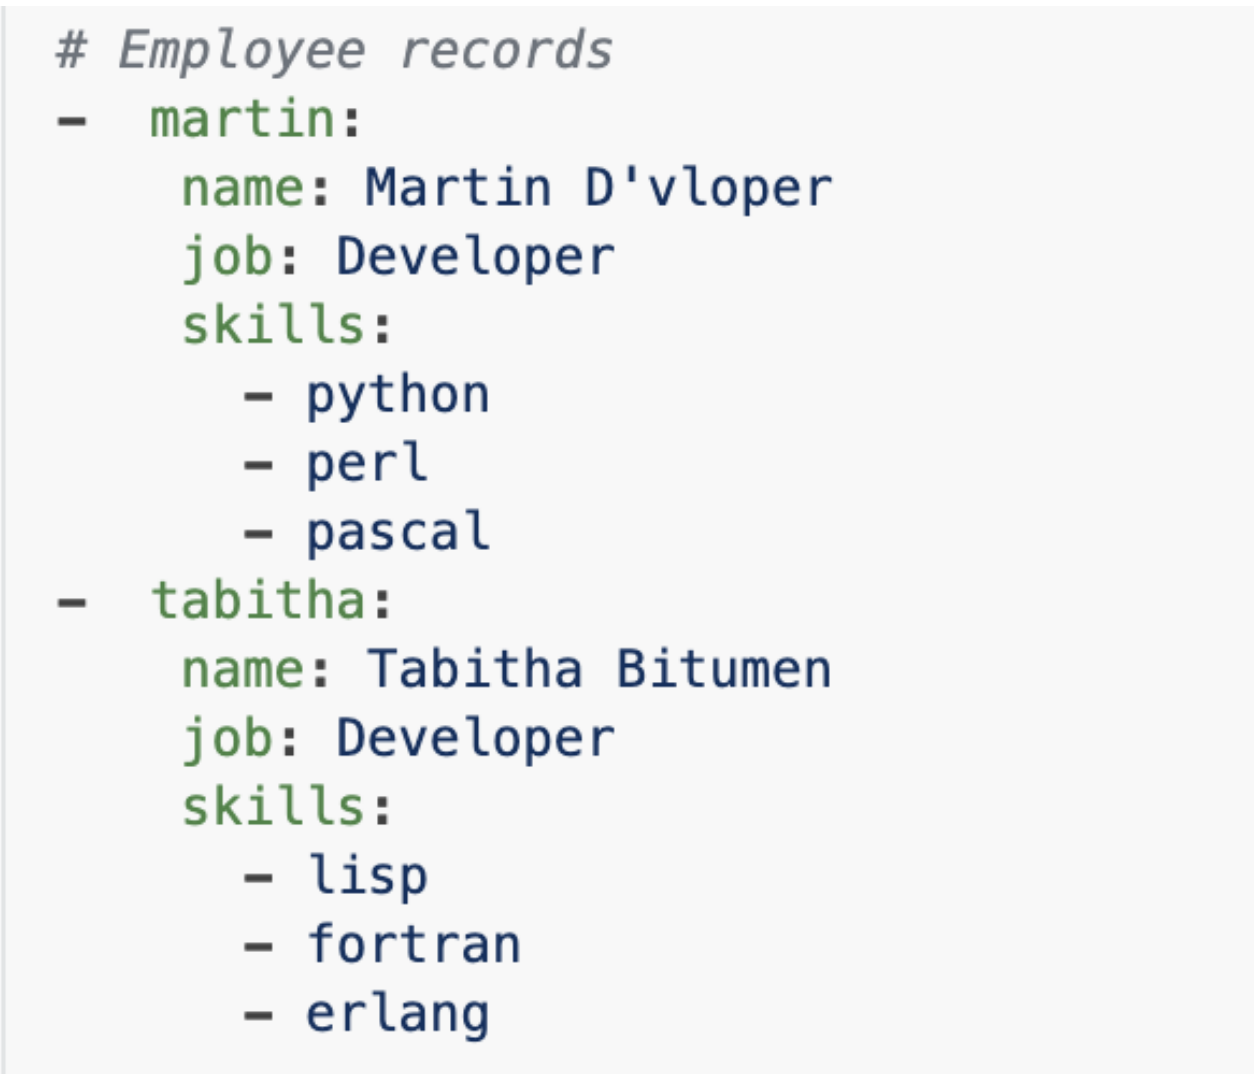
- YAML(YAML Ain't Markup Language) onderscheidt data met tabs en regeleindes.
-
JSON(Javascript object notation) maakt gebruik van diverse leestekens (komma’s, aanhalingstekens…) en akkolades.
Voorbeelden
XML-bestand

YAML-bestand
CSV-bestand

ICAL

JSON